AI TOP ATOM vs DGX Spark: quais são as diferenças reais?
Uma GIGABYTE AI TOP ATOM e um DGX Spark da NVIDIA usam o mesmo chip GB10 e os mesmos 128 GB de memória. Nossas medições diferem no máximo 4,3% das publicadas para o DGX Spark com llama.cpp e no máximo 2% com Ollama. A GIGABYTE fornece seu próprio chassi, no mesmo formato de um litro da Founders Edition, seu sistema de refrigeração e suas seis referências. Durante 2 horas de carga contínua, a velocidade permaneceu estável, sem qualquer redução de desempenho imposta.
O DGX Spark da NVIDIA e o AI TOP ATOM da GIGABYTE usam o mesmo chip GB10. O que realmente muda? Em nosso AI TOP ATOM, cedido gratuitamente pela GIGABYTE, repetimos três séries de medições publicadas para o DGX Spark e depois medimos seu comportamento sob carga durante 1 e 2 horas, suas temperaturas e seu SSD, além de verificarmos suas portas. Os preços por referência e nossas recomendações de compra vêm a seguir.
#Mesmo chip NVIDIA GB10, fabricação GIGABYTE
O DGX Spark é uma plataforma de NVIDIA. Seu chip GB10 reúne 20 núcleos Arm e uma GPU da geração Blackwell, que compartilham 128 GB de memória anunciada a 273 GB/s. NVIDIA também fornece o sistema DGX OS, o driver e o CUDA. O DGX Spark vendido pela NVIDIA é chamado Founders Edition. Outros fabricantes, incluindo a GIGABYTE, oferecem sua própria máquina com a mesma base.
Essa separação organiza todo o guia. O que vem de NVIDIA aparece em todas as máquinas GB10: a seção seguinte verifica isso por meio de medições. O que vem da GIGABYTE é avaliado no chassi, no sistema de refrigeração, no armazenamento, nas referências e na garantia. A StorageReview, um site americano de testes de hardware, escreve que, como todas essas máquinas compartilham a mesma base GB10, a diferença de desempenho em IA permanece pequena.
| Elemento | Fornecido por | No nosso AI TOP ATOM |
|---|---|---|
| Chip GB10: 20 núcleos Arm, GPU Blackwell | NVIDIA | Velocidades a menos de 5% das publicadas (seção seguinte) |
| Memória unificada de 128 GB, 273 GB/s | NVIDIA (plataforma) | O sistema vê 121,7 GB; uma parte fica reservada para a inicialização |
| DGX OS, driver, CUDA | NVIDIA | DGX OS 7.5.0, driver 580.159.03, CUDA 13.0 |
| Formato de 150 × 150 × 50,5 mm e 1,2 kg | Mesmo formato da Founders Edition | Gabinete preto fosco, painel frontal com lâminas, sem porta nem botão |
| Resfriamento e acabamento | GIGABYTE | Dissipador, placas de cobre, tubos de calor e duas ventoinhas, segundo a ServeTheHome |
| SSD: capacidade e geração PCIe | GIGABYTE (conforme a referência) | Samsung de 4 TB, PCIe 5.0 verificado (32 GT/s em 4 pistas) |
| Fonte de alimentação de 240 W via USB-C | GIGABYTE (adaptador fornecido) | NVIDIA exige o uso da fonte de alimentação fornecida |
| Referências, preço, garantia | GIGABYTE e revendedores | Ver as seções de referências e preços |
#As mesmas velocidades do DGX Spark: três verificações
Para comparar o ATOM com as referências do DGX Spark, reproduzimos três medições publicadas para essa máquina, usando a mesma ferramenta. Para llama.cpp e Ollama, a versão e as configurações também são as mesmas; para o vLLM, a versão e o comando não foram publicados. Se nosso ATOM apresentar os mesmos números, ele terá o mesmo desempenho da referência.
#Método e unidades
Cada velocidade do llama.cpp é a média de 5 repetições, com um desvio-padrão inferior a 3% (o desvio-padrão mede a dispersão das repetições). A velocidade de leitura é aquela com que a máquina absorve seu texto antes de responder. A velocidade de escrita é a da resposta que aparece.
Ambas são medidas em tokens por segundo (tok/s); um token é um fragmento de palavra, aproximadamente dois terços de uma palavra em francês. As memórias e as taxas de transferência dos discos são expressas em GB e GB/s, como exibido pelo Linux: 1 GB = 1.024 MB.
O protocolo foi definido antes da primeira medição. Cada teste adicionado depois é descrito em um adendo datado, escrito antes do teste. O método, a lista datada dos adendos e os dados de nossas tabelas estão publicados em nossa página de metodologia.
#Com llama.cpp: com diferença de até 4,3%
llama.cpp é um mecanismo open source muito difundido para executar modelos localmente. O projeto publica uma tabela de referência para o DGX Spark, no build 7941 (o número da versão do software), em fevereiro de 2026. Compilamos o mesmo build e executamos o mesmo comando em seis modelos e cinco profundidades de contexto, totalizando 60 pontos de medição. O contexto é o texto já presente na memória: de 0 a 32 768 tokens.
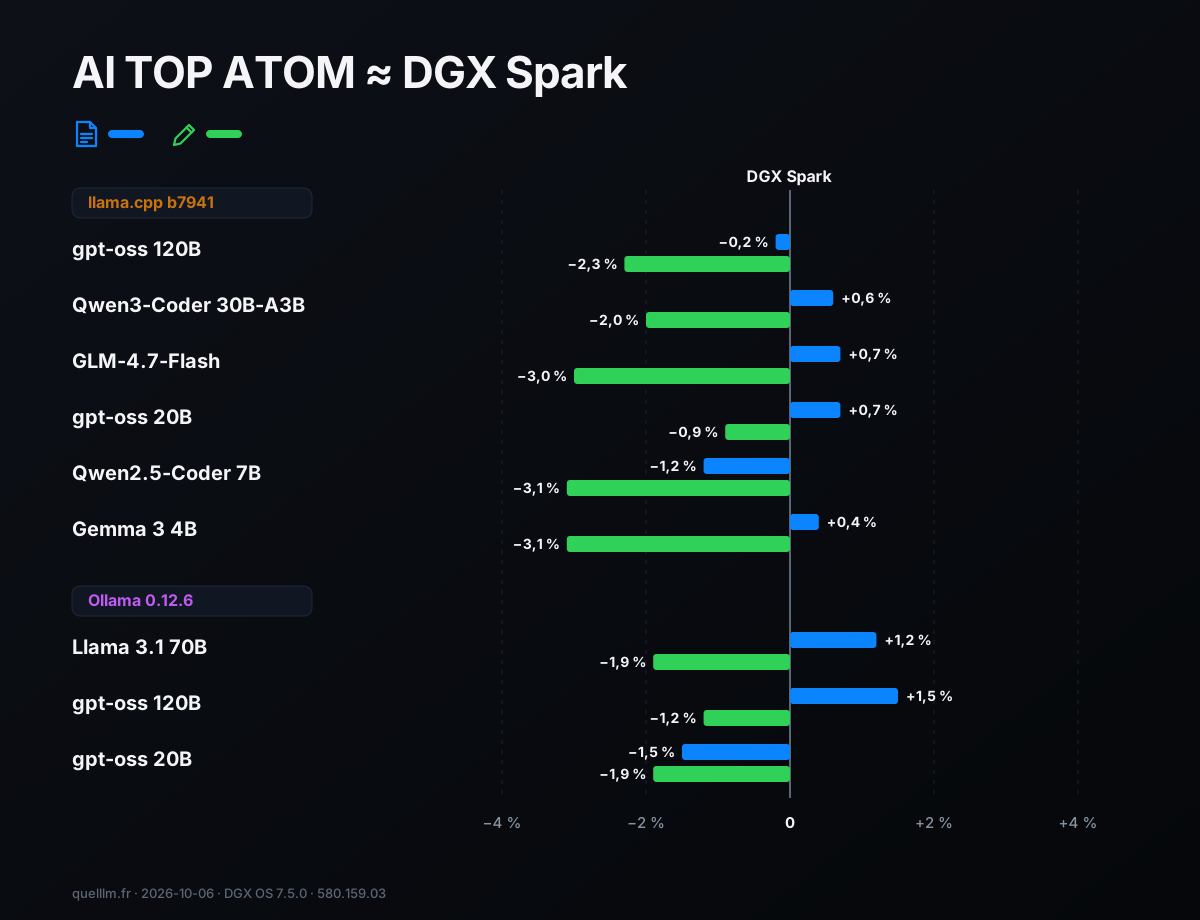
Resultado: a velocidade de leitura é idêntica com uma diferença de até 2,3%, com uma diferença mediana de +0,3%. A velocidade de gravação permanece no mesmo nível, com uma diferença mediana de −2,8% (4,3% no máximo). Para gpt-oss 120B, a leitura com contexto vazio é igual à referência: 2 443,9 tok/s dos dois lados. A tabela de referência é de um driver mais antigo (580.95.05) que o nosso (580.159.03).
#Com o script oficial do Ollama: a 2% de distância
Ollama publicou suas próprias medições para o DGX Spark em outubro de 2025, com sua versão 0.12.6 e o driver 580.95.05. Usamos a mesma versão e o mesmo script, com 10 execuções e temperatura 0. Os três modelos publicados apresentam resultados com diferença de até 2%, tanto na leitura quanto na gravação.
| Modelo | Leitura: nós / publicado | Diferença | Escrita: nossa medição / publicado | Diferença |
|---|---|---|---|---|
| gpt-oss 20B | 3 175,0 / 3 224 | −1,5 % | 57,18 / 58,27 | −1,9 % |
| gpt-oss 120B | 1 186,8 / 1 169 | +1,5 % | 40,65 / 41,14 | −1,2 % |
| Llama 3.1 70B | 1 933,6 / 1 911 | +1,2 % | 4,34 / 4,423 | −1,9 % |
#Com o vLLM: mesma ordem de grandeza, mecanismo diferente
A StorageReview mediu o ATOM em 3 de março de 2026 com o vLLM, um servidor projetado para responder a várias pessoas ao mesmo tempo, em gpt-oss 120B. A StorageReview não publica a versão do vLLM nem o comando exato. Repetimos seus três cenários com o vLLM 26.09, para 1 e para 64 usuários.
Nossas taxas de transferência são da mesma ordem de grandeza que as dele, acima ou abaixo conforme o cenário. Com um usuário, no cenário em que a máquina lê 4 096 tokens e grava 512, obtemos 304,4 tokens por segundo no total, contra 304,6 da StorageReview.
Com 64 usuários, no cenário equilibrado (256 tokens lidos, 256 escritos), alcançamos 695 tokens por segundo, contra 650. Como a versão do vLLM não é a mesma, apresentamos esses números como uma mesma ordem de grandeza, e não como uma comparação entre máquinas. Durante esses testes, nenhuma solicitação foi interrompida.
Em resumo: com llama.cpp e Ollama, dois mecanismos muito usados localmente, o ATOM oferece, com diferença inferior a 5%, o mesmo desempenho que um DGX Spark. Para a velocidade de cada modelo nesse chip, consulte nosso primeiro guia da série.
#O que a GIGABYTE oferece: gabinete, refrigeração, referências
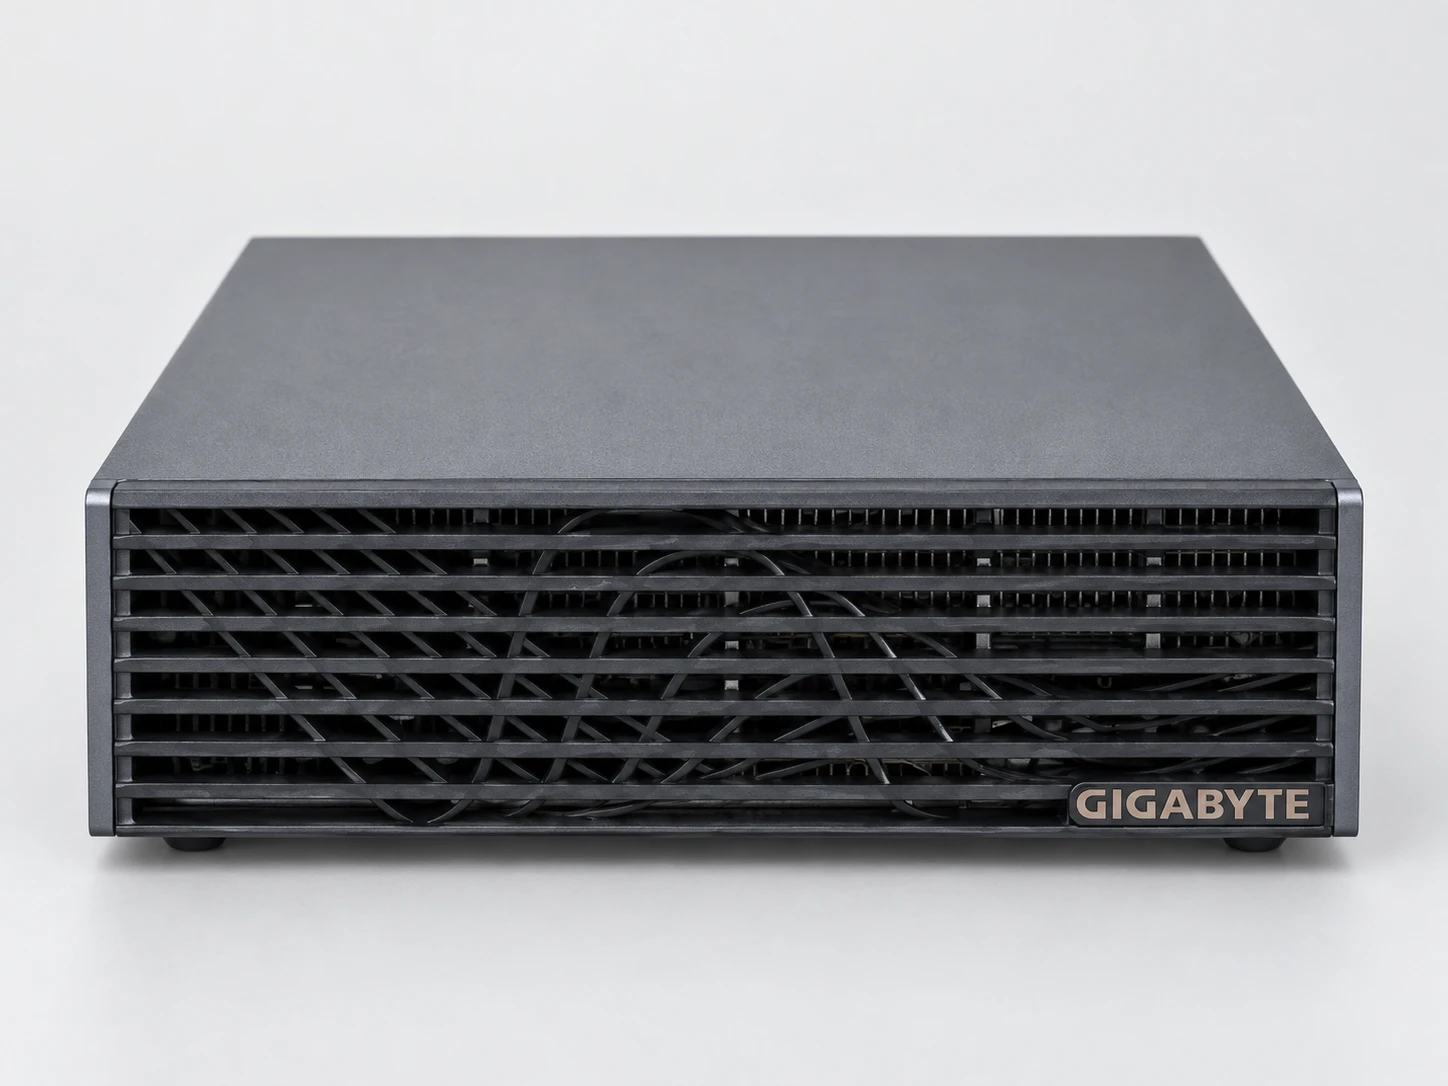
A AI TOP ATOM mede 150 × 150 × 50,5 mm e pesa 1,2 kg, ou seja, tem um volume de cerca de um litro: esse é o formato da Founders Edition. O gabinete é preto fosco. A fachada tem lâminas, com um padrão ondulado, e não possui porta nem botão: tudo é conectado na parte traseira.
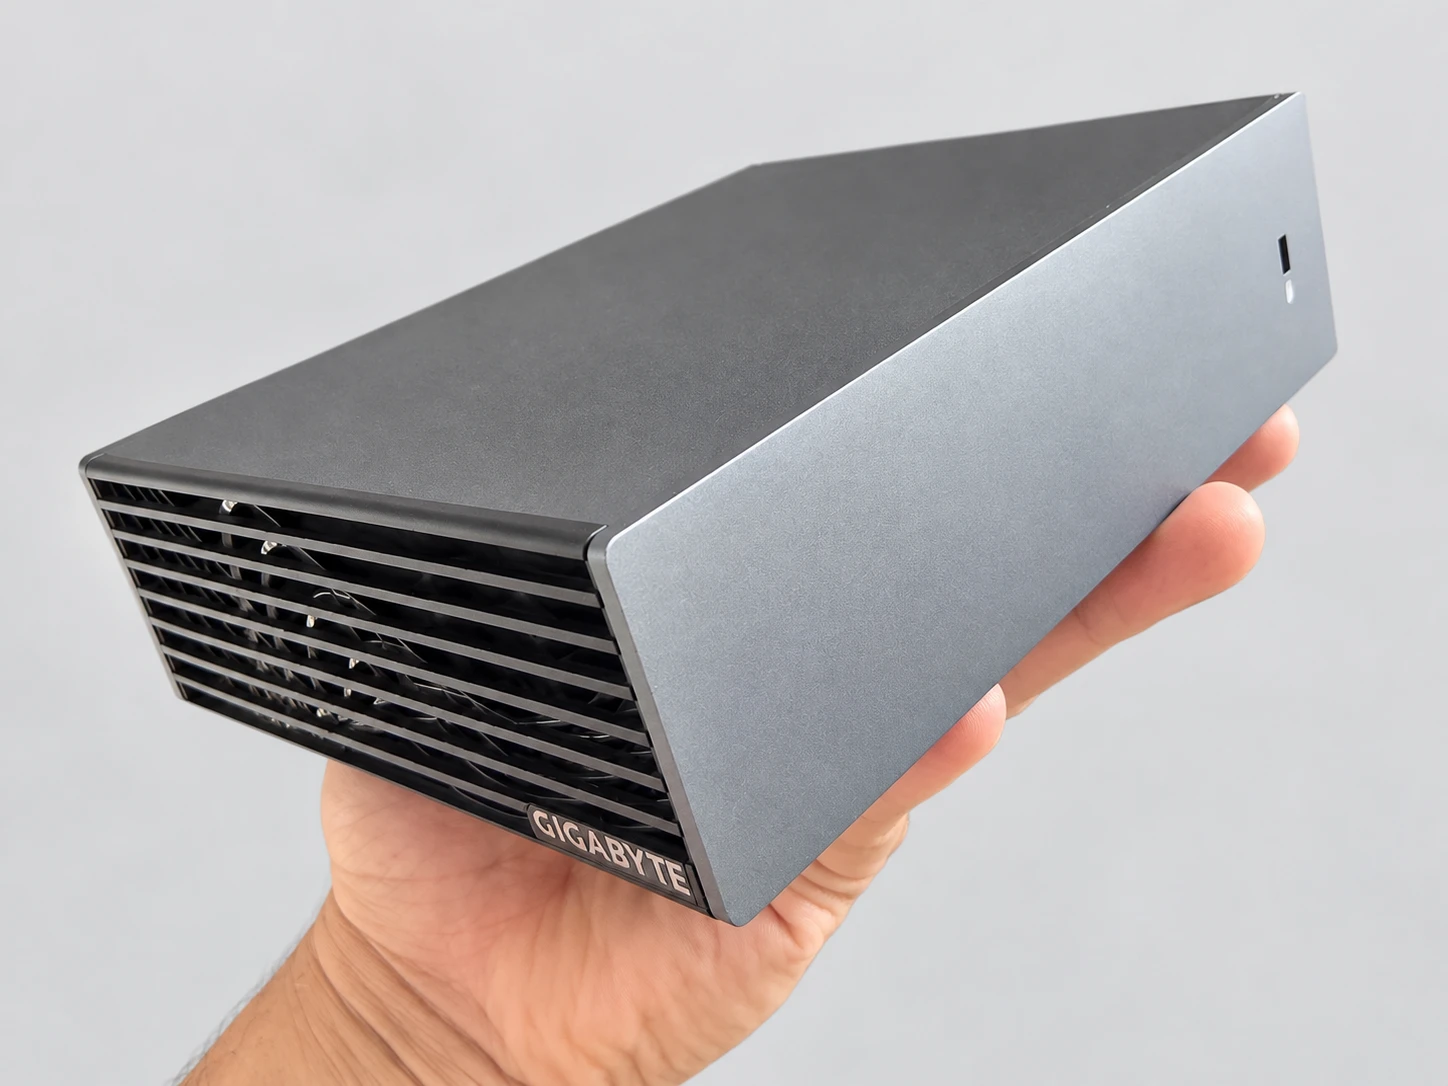
A ServeTheHome abriu a máquina. Ela descreve um dissipador grande, com placas de cobre sobre os chips e heat pipes, resfriado por duas ventoinhas Delta. A StorageReview comparou cinco máquinas GB10 em janeiro de 2026. A GIGABYTE chega a no máximo 87 a 88 °C no pico de carga, assim como a Founders Edition e a máquina da Dell.
A StorageReview o classifica entre os melhores perfis de resfriamento, com um dos níveis mais altos de potência da GPU. Depois de mais de uma hora de aquecimento, a ServeTheHome considera o ATOM no nível da DGX Spark de NVIDIA, com uma ligeira vantagem em vários de seus testes de IA.
Peter Falkingham, que usa uma ATOM desde julho de 2026 em um laboratório universitário, descreve-a em seu teste como quase silenciosa.
#Seis referências, com um SSD à escolha
A página do produto da GIGABYTE lista seis referências, de ATAGB10-9000 a ATAGB10-9005. A tabela mostra aquelas que conseguimos verificar.
| Referência | Memória | SSD |
|---|---|---|
| ATAGB10-9000 (nossa unidade) | 128 GB | 4 TB em PCIe 5.0 |
| ATAGB10-9001 | 128 GB | 4 TB em PCIe 4.0 |
| ATAGB10-9002 | 128 GB | 1 TB em PCIe 4.0 |
| ATAGB10-9003 a 9005 | 128 GB ou 64 GB | 2 TB ou 1 TB em PCIe 4.0 (não verificado referência por referência) |
Na 9000, o SSD é um Samsung da família PM9E1, o mesmo modelo da Founders Edition, segundo a StorageReview. É um módulo M.2 2242. Segundo a ServeTheHome, é o único componente que o usuário pode substituir.
#Fonte de alimentação, caixa e garantia
O adaptador de 240 W é conectado à porta USB-C reservada para a alimentação. NVIDIA recomenda usar a fonte de alimentação fornecida para obter o desempenho ideal. A caixa contém a máquina, o adaptador e o cabo de alimentação. Um cabo QSFP para conectar duas máquinas é vendido separadamente pela GIGABYTE: 94,04 € com impostos na loja oficial da AORUS (valor verificado em 8 de outubro de 2026).
Quanto à garantia, o manual da GIGABYTE indica que a duração é informada no site do produto ou na etiqueta. A LDLC anuncia 5 anos de garantia para a 9000 (registrado em 8 de outubro de 2026). Leia o prazo na ficha do revendedor antes de comprar.
#Portas e conectividade
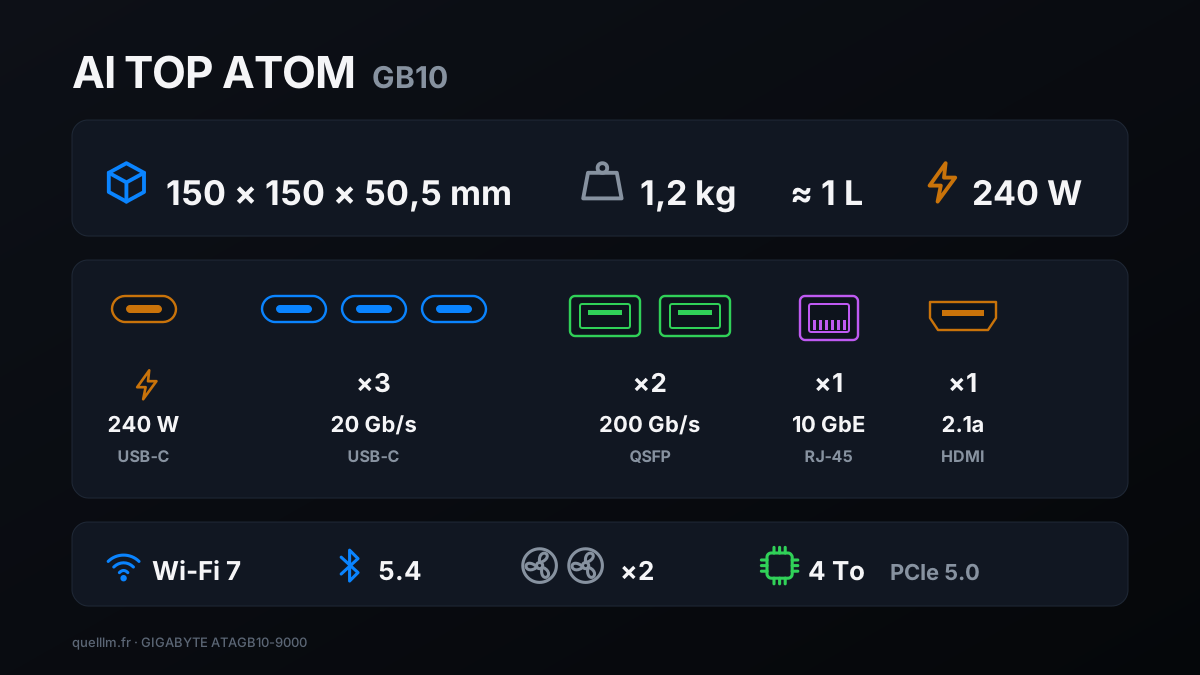
A lista reproduz a ficha da GIGABYTE, e a ficha de NVIDIA para a Founders Edition indica as mesmas portas. Em nossa unidade, verificamos a rede cabeada e a conexão do SSD, e identificamos o módulo Wi-Fi.
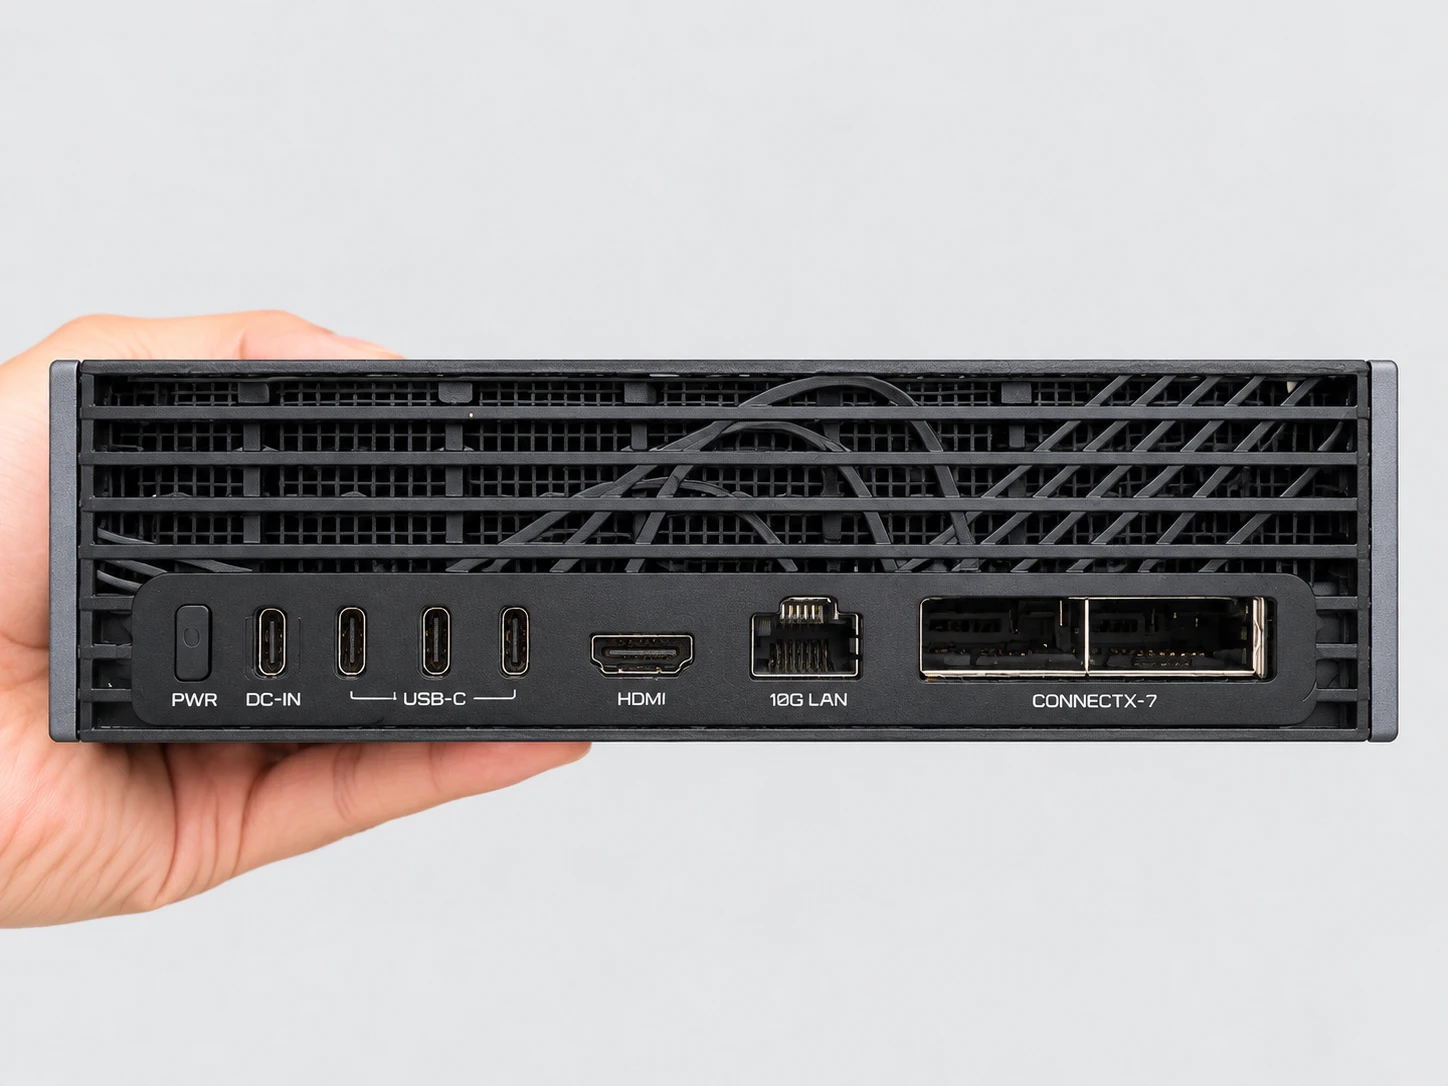
- Alimentação
- Uma porta USB-C reservada para alimentação, com o adaptador de 240 W fornecido.
- USB
- Três portas USB-C de 20 Gb/s (USB 3.2 Gen 2x2) para discos e acessórios.
- Rede cabeada
- Uma porta RJ-45 de 10 GbE. Em nossa unidade, o link negociado é de 10 Gb/s.
- Rede de alta velocidade
- Duas portas QSFP (placa NVIDIA ConnectX-7, 200 Gb/s) para conectar várias máquinas. Não testamos essa conexão.
- Vídeo
- Uma saída HDMI 2.1a, com áudio multicanal.
- Sem fio
- Wi-Fi 7 e Bluetooth 5.4. Nosso sistema identifica um chip MediaTek MT7925.
#Comportamento sob carga: 1 hora e 2 horas seguidas
Uma máquina compacta precisa suportar a carga sem ficar mais lenta. Uma redução de velocidade imposta pelo calor ou pelo limite de potência é chamada de throttling. Fizemos a ATOM trabalhar sem pausa com o vLLM 26.09. Cada sessão é dividida em lotes: um lote é um conjunto de solicitações enviado em seguida ao anterior. Durante esse período, registramos a cada segundo o clock da GPU, sua potência, sua temperatura e os motivos de throttling informados pelo driver.
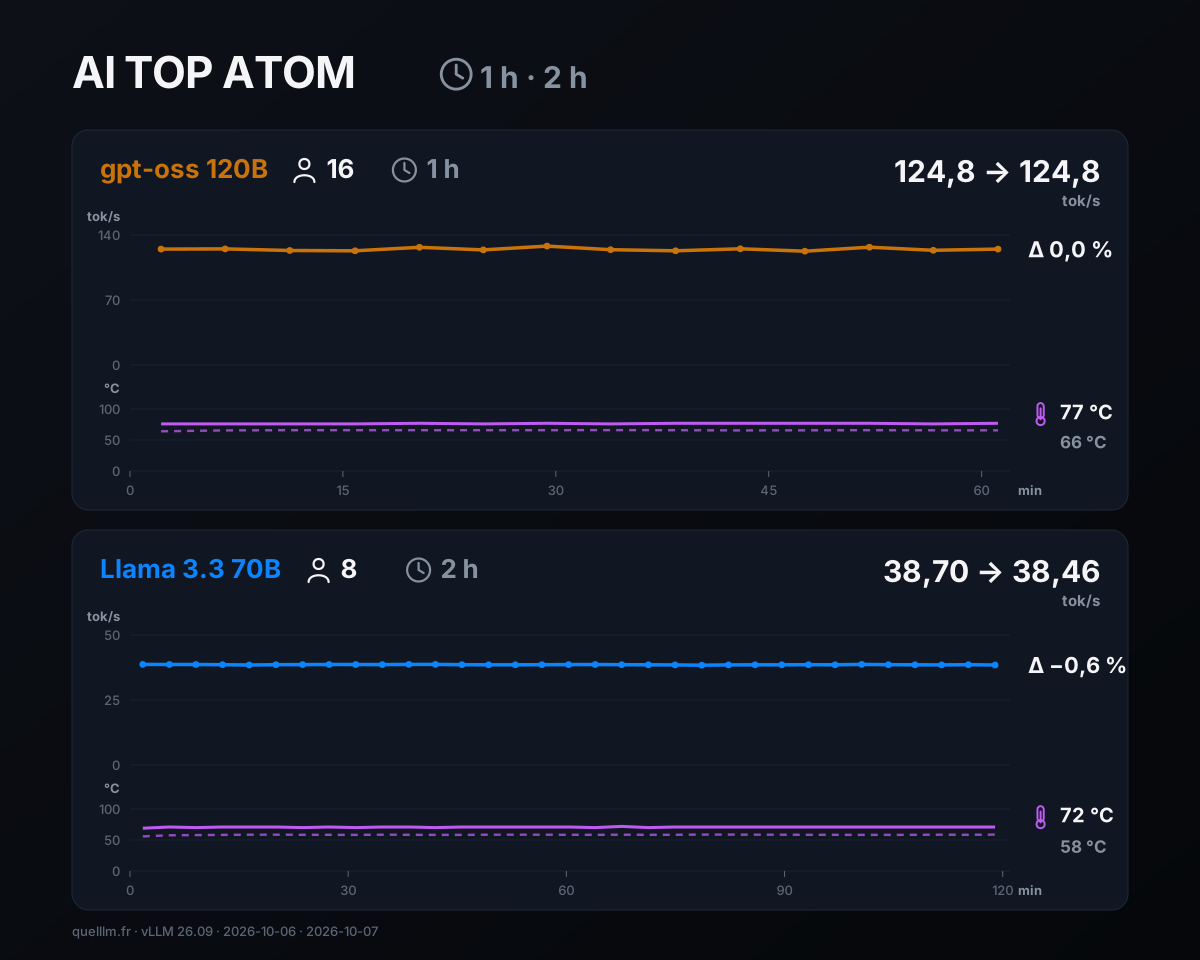
| Sessão | Solicitações | Taxa de transferência: primeiro → último bloco | Deriva | Temperatura da GPU | Bridage |
|---|---|---|---|---|---|
| 1 h, gpt-oss 120B, 16 usuários, 14 lotes | 896, nenhuma falha | 124,8 → 124,8 (de 122,6 a 128,1) | 0,0 % | 77 °C / 66 °C | Nenhum |
| 2 h, Llama 3.3 70B NVFP4, 8 usuários, 33 intervalos | 1.056, nenhuma falha | 38,70 → 38,46 (de 38,40 a 38,70) | −0,6 % | 72 °C / 58 °C | Nenhum |
Durante uma hora, 16 usuários enviaram continuamente solicitações de 4 096 tokens, com respostas de 512 tokens. Os 14 intervalos de 64 solicitações apresentaram uma vazão quase idêntica, de 122,6 a 128,1 tok/s no total, e tanto o primeiro quanto o último alcançaram 124,8 tok/s. Cada pessoa via sua resposta sendo escrita a cerca de 8 tok/s. O clock da GPU teve mediana de 2 509 MHz nessa sessão.
Durante duas horas, 8 usuários trabalharam com Llama 3.3 70B no formato NVFP4, um formato compactado de NVIDIA, com 1 024 tokens lidos e 256 escritos por solicitação. A vazão total permaneceu entre 38,40 e 38,70 tok/s em 33 intervalos de 32 solicitações.
A deriva é de −0,6% entre o primeiro e o último intervalo, e de −0,2% ao comparar as medianas dos cinco primeiros e dos cinco últimos. Cada pessoa via sua resposta sendo escrita a cerca de 5,1 tok/s, e a primeira palavra chegava em 2,8 s (mediana). O clock da GPU teve mediana de 2 528 MHz.
O driver não declarou nenhum motivo para limitar o desempenho durante as duas sessões: o valor registrado permaneceu em zero, segundo após segundo. A GPU atingiu no máximo 77 °C com 16 usuários e 72 °C com 8 usuários. A zona mais quente dos sensores do sistema atingiu 87 °C durante a primeira sessão e 80 °C durante a segunda.
Durante a segunda, o SSD atingiu no máximo 49 °C. O firmware não nomeia essas zonas; não as atribuímos ao processador. Para comparação, a StorageReview registrou no máximo 87 a 88 °C no pico de carga na Founders Edition, na máquina da Dell e na GIGABYTE.
#Em repouso
Após 20 minutos em repouso, monitoramos a máquina durante 30 minutos. A GPU consome em média 10,4 W (de 10,2 a 11,0 W) e permanece entre 35 e 36 °C. A área mais quente dos sensores do sistema chega no máximo a 46 °C, e o SSD permanece entre 34 e 35 °C. Nenhum motivo para redução de desempenho foi declarado.
A potência indicada é a da GPU, informada pelos sensores dela; ela não representa o consumo total da máquina. A temperatura ambiente não foi registrada. A sessão de uma hora ocorreu no início da noite, e a de 2 horas, à noite, quando o ambiente provavelmente estava mais fresco.
#O SSD: 13 GB/s de leitura, 1,28 milhão de IOPS
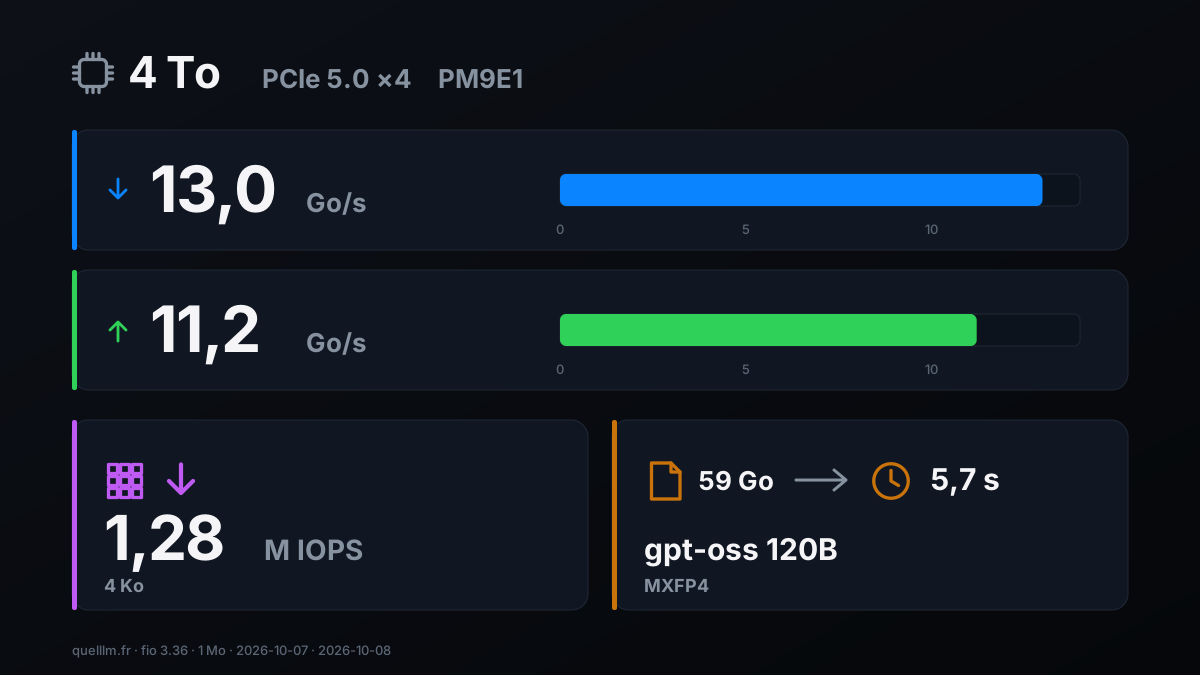
A referência 9000 vem com um SSD Samsung MZALC4T0HBL1 de 4 TB, da família PM9E1. O sistema confirma um link PCIe 5.0: 32 GT/s em 4 pistas. PCIe é a conexão entre o SSD e o chip; a versão 5.0 é duas vezes mais rápida que a 4.0.
Medimos isso com o fio 3.36, em um arquivo de 64 GB completamente escrito antes da leitura, com acesso direto, ou seja, sem passar pelo cache do sistema. IOPS é o número de operações de leitura ou escrita por segundo.
| Test | Resultado |
|---|---|
| Leitura sequencial, blocos de 1 MB, 1 tarefa | 13,0 GB/s (12,99 com io_uring, 13,37 com libaio, dois métodos de acesso ao disco do Linux) |
| Leitura aleatória, blocos de 4 Ko, 4 tarefas | 1,28 milhão de IOPS com io_uring, 1,19 milhão com libaio (cerca de 4,9 GB/s com io_uring) |
| Escrita sequencial em rajada, blocos de 1 MB, arquivo novo de 32 GB, disco em repouso | 11,2 GB/s |
| Leitura do arquivo de gpt-oss 120B (59 GB) | 5,7 s |
A StorageReview publicou, com outra ferramenta (gdsio) e o mesmo modelo de SSD, 11,0 a 11,6 GB/s de leitura e 12,2 GB/s de gravação. Nossos valores são da mesma ordem de grandeza, com uma leitura um pouco mais alta. Na prática, um modelo grande é carregado em poucos segundos: o arquivo de gpt-oss 120B, de 59 GB, foi lido em 5,7 s.
Na 9000, você encontra o SSD da Founders Edition de 4 TB: é o mesmo modelo e, portanto, não distingue a ATOM da referência NVIDIA. A diferença existe entre as referências da GIGABYTE: a 9000 tem um SSD PCIe 5.0, e a 9001 e a 9002, PCIe 4.0. As medições do SSD referem-se à referência 9000.
#64 ou 128 GB?
Em 2 de outubro de 2026, NVIDIA anunciou um DGX Spark de 64 GB para modelos de até 100 bilhões de parâmetros, disponível em 23 de outubro na Acer, ASUS, Dell, GIGABYTE, HP e MSI, a partir de 4.999 dólares. A GIGABYTE confirmou em 5 de outubro uma AI TOP ATOM de 64 GB com o mesmo design. A disponibilidade na França não está confirmada até o momento. Nós não a medimos.
Nossas medições do primeiro guia da série permitem fazer um cálculo. Os modelos até Qwen3-Coder 30B-A3B ocupam menos de 35 GB com 32 768 tokens de contexto e caberiam em 64 GB. Llama 3.3 70B (51 GB) estaria no limite. gpt-oss 120B (62 GB) e os modelos maiores não caberiam. Com a mesma largura de banda, algo que ainda será preciso verificar, as velocidades devem ser próximas.
Para executar um modelo com mais de 100 bilhões de parâmetros em uma única máquina, é necessária a versão de 128 GB. As seis referências da página da GIGABYTE permitem escolher a memória e o SSD.
#Preço por referência (levantamentos de 8 de outubro de 2026)
Os preços do GB10 mudam toda semana: verifique-os antes de comprar. Veja o que registramos em 8 de outubro de 2026 na França, com impostos incluídos. Compare sempre a mesma referência: a 9001 (PCIe 4.0) e a 9000 (PCIe 5.0) não são a mesma máquina.
| Marchand | Referência | Preço com impostos incluídos | Disponibilidade exibida |
|---|---|---|---|
| Loja oficial da AORUS | 9001 (4 TB em PCIe 4.0) | 6 346,27 € | Esgotada |
| Amazon.fr, vendido pela Amazon UK | 9001 (4 TB em PCIe 4.0) | Preço variável, consulte na Amazon.fr | 1 unidade |
| LDLC | 9000 (4 TB em PCIe 5.0) | 7 999,95 € | Rupture |
| Rue du Commerce, vendedores terceiros | 9000 (4 TB em PCIe 5.0) | A partir de 7 999,95 € (3 ofertas) | De acordo com o vendedor |
| Senetic.fr | 9000 (4 TB em PCIe 5.0) | 9 022,08 € | 5 unidades |
A Materiel.net anunciava o mesmo preço que a LDLC para a 9000, também esgotada. Para comparar, no mesmo dia, a MSI EdgeXpert, outra máquina GB10, era anunciada por 6 599,95 € na Materiel.net, também esgotada; a DGX Spark da PNY já não era oferecida lá, nem na LDLC. Um preço anunciado para uma máquina indisponível não é um preço de compra: verifique também a disponibilidade.
#O que não medimos
- A comparação com o DGX Spark
- A comparação se baseia nas medições publicadas para o DGX Spark, reproduzidas na ATOM com as versões de software indicadas.
- O ruído
- A avaliação do ruído mencionada nesta página vem do teste de Peter Falkingham.
- O consumo da máquina inteira
- As potências desta página correspondem somente à GPU. Um próximo guia da série detalhará o consumo.
- A temperatura do ambiente
- As temperaturas publicadas vêm dos sensores integrados à máquina.
- A conexão entre duas máquinas
- As duas portas QSFP (200 Gb/s) não foram testadas.
- As outras referências e a versão de 64 GB
- As medições referem-se à ATAGB10-9000 de 128 GB.
Esta página será atualizada se uma nova versão do DGX OS, do firmware ou de nossas ferramentas alterar esses resultados; cada correção será datada.
#Para quem a AI TOP ATOM é a escolha certa
O que segue vem das nossas medições da referência 9000 e dos nossos levantamentos de preços de 8 de outubro de 2026.
- Você quer o desempenho de referência do GB10 em um gabinete elegante
- A 9000 oferece, com no máximo 4,3% de diferença, as velocidades publicadas para o DGX Spark, com um SSD de 4 TB em PCIe 5.0 medido a 13 GB/s em leitura.
- … você mantém a máquina na sua mesa
- Ela cabe em um litro, pesa 1,2 kg e tem uma fachada minimalista. Em repouso, a GPU consome cerca de 10 W.
- … você atende a uma equipe ou a agentes de IA
- Uma hora com 16 usuários em gpt-oss 120B, depois duas horas com 8 usuários em Llama 3.3 70B: a velocidade permaneceu estável (deriva de 0,0% e de −0,6%), sem qualquer limitação.
- … você quer pagar menos sem trocar o chip
- A 9001, com um SSD de 4 TB em PCIe 4.0, estava anunciada por 6 346,27 € na loja oficial da AORUS em 8 de outubro de 2026, esgotada, e disponível na Amazon.fr. Ela tem o mesmo chip e os mesmos 128 GB; os levantamentos desta página referem-se à 9000.
- … seus modelos ocupam menos de 35 GB com o contexto deles
- A versão de 64 GB, anunciada para 23 de outubro de 2026, deve ser suficiente (cálculo extraído do nosso primeiro guia, não medido nessa versão). Aguarde a disponibilidade e o preço.
- … você quer conectar várias máquinas
- As duas portas QSFP (200 Gb/s) foram previstas para esse uso. A GIGABYTE vende o cabo separadamente.
#FAQ
A AI TOP ATOM é tão rápida quanto um DGX Spark de NVIDIA?+
O que muda concretamente entre uma ATOM e uma Founders Edition?+
A AI TOP ATOM fica mais lenta quando trabalha por muito tempo?+
Qual referência escolher: 9000, 9001 ou 9002?+
É preciso esperar pela versão de 64 GB?+
Um comentário, um erro ou uma observação? Avise-nos; isso ajuda a melhorar o guia para todos.