Fine-tuning local no GB10: medições e metodologia
Em um GIGABYTE AI TOP ATOM (chip NVIDIA GB10, 128 GB), um modelo pequeno treinado para uma tarefa específica pode superar um modelo muito grande nessa tarefa. Em 85 minutos de LoRA, o Qwen3-8B extrai sem nenhum erro os dados de 95% de 200 faturas fictícias nunca vistas, contra 62,5% do gpt-oss 120B e 26% sem treinamento. O QLoRA com o Unsloth também cabe na memória: 41 GB para um 70B, 64 GB para o gpt-oss 120B. O treinamento custou 1,5 centavo de euro de eletricidade na GPU.
O fine-tuning treina um pouco mais um modelo existente para que ele se saia bem em uma tarefa específica. Com 128 GB de memória unificada, uma máquina GB10 faz isso na sua casa, sem que você precise alugar um servidor nem confiar seus dados a um serviço on-line. Este guia acompanha um caso completo, medido em uma AI TOP ATOM cedida gratuitamente pela GIGABYTE: extrair em JSON os dados de faturas. Ele também traz as medições do QLoRA (o mesmo método em um modelo comprimido em 4 bits) com o Unsloth até gpt-oss 120B, além dos comandos dos nossos testes.
#O caso real: ler faturas e gerar JSON
A tarefa é comum em uma pequena empresa: a partir do texto de uma fatura, de um orçamento ou de uma nota de crédito, o modelo precisa retornar um JSON, ou seja, uma ficha estruturada que um software consegue ler. Essa ficha tem 31 campos avaliados: tipo de documento, número, datas, emitente, cliente, linhas de produtos, desconto, totais, TVA, adiantamento, IBAN. Escolhemos essa tarefa porque a resposta pode ser verificada campo a campo, sem que outro modelo precise julgar.
Os documentos são fictícios. Um pequeno programa gerou 12 layouts, ou seja, 12 formatos de fatura, com nomes de empresas inventados. A aleatoriedade dele é controlada por uma “semente” fixa: ele gera os mesmos documentos a cada execução. O treinamento usa 2.000 documentos em 10 layouts.
A avaliação usa 200 documentos nunca vistos: 100 com os mesmos 10 layouts e 100 com 2 layouts ausentes do treinamento. Esses últimos 100 mostram se o modelo entendeu a tarefa ou se apenas memorizou formatos.
O modelo recebe o texto do documento, não uma imagem nem um PDF. Veja um trecho da resposta do modelo treinado para o primeiro documento de teste, uma nota de crédito fictícia de quatro linhas.
#O método: LoRA, uma época, 85 minutos
Aproveite a nossa experiência e um percurso guiado para criar o seu assistente local e usar a sua IA no dia a dia.
- Espaço online vitalício
- PDF + arquivos
- Reembolsado em 30 dias
A máquina é uma GIGABYTE AI TOP ATOM, referência ATAGB10-9000: chip NVIDIA GB10, 128 GB de memória unificada, SSD de 4 TB em PCIe 5.0, com DGX OS 7.5.0 (driver 580.159.03, CUDA 13.0). Os softwares: o contêiner PyTorch da NVIDIA (versão 26.03, com PyTorch 2.11), PEFT 0.21.2 para o LoRA, Unsloth 2026.10.1 para o QLoRA e, para servir o modelo, o contêiner vLLM 26.09 da NVIDIA (vLLM 0.29.0). Nosso primeiro guia da série detalha a máquina e a velocidade de 13 modelos.
O LoRA (Low-Rank Adaptation) mantém o modelo original intacto e treina pequenas matrizes adicionadas às suas camadas. O resultado é um adaptador, um pequeno arquivo carregado junto com o modelo. Aqui, são treinados 43,6 milhões de parâmetros, contra 8 bilhões do Qwen3-8B.
Três termos aparecem com frequência neste guia. Um passo de treinamento processa um lote de 4 documentos. Uma época é uma passagem completa pelos 2.000 documentos. A perda mede a diferença entre a resposta escrita pelo modelo e a resposta esperada: quanto mais baixa, melhor.
- Modelo
- Qwen3-8B em bf16, um formato numérico de 16 bits, sem compressão.
- LoRA
- Rank 16, alpha 32 (um coeficiente de escala), dropout 0,05 (uma pequena parte dos valores é ignorada aleatoriamente a cada passo, para limitar o sobreajuste), nas 7 projeções de cada camada, ou seja, em suas 7 matrizes de pesos: q, k, v, o, gate, up, down. O rank define o tamanho das matrizes adicionadas.
- Duração
- 1 época: 500 passos de 4 documentos.
- Taxa de aprendizado
- 1e-4, ou seja, 0,0001, com aumento gradual ao longo de 30 passos e depois decaimento cosseno.
- Lots
- Ordenamos os 2.000 documentos por comprimento, formamos os lotes e depois embaralhamos a ordem deles com uma semente fixa. Um lote contém documentos de comprimento parecido: há menos preenchimento desnecessário, então o treinamento fica mais rápido.
- Perte
- Calculada apenas sobre a resposta JSON. O prompt e o documento ficam mascarados: o modelo aprende a escrever a resposta, não a copiar o documento.
- Comprimento
- Até 2.304 tokens. O documento mais longo tem 2.204, e a média é de 1.143: nenhum é cortado.
- Memória
- O gradient checkpointing está ativo: o modelo recalcula alguns resultados em vez de manter todos na memória.
Estas configurações foram definidas por um adendo ao nosso protocolo, datado de 7 de outubro de 2026, antes de qualquer avaliação com os 200 documentos de teste. O protocolo foi congelado antes da primeira medição; o método, a lista datada dos adendos e os dados das nossas tabelas estão publicados na nossa página de metodologia. As memórias deste guia estão em GB, como o Linux as exibe: 1 GB = 1.024 MB.
Tudo acontece no contêiner PyTorch da NVIDIA (versão 26.03). Nele, um ambiente Python recebe as bibliotecas transformers e PEFT. Os caminhos abaixo estão simplificados; as opções são as dos nossos testes.
#Os resultados: 95% de documentos perfeitos
A nota compara, campo a campo, o valor escrito pelo modelo com o valor esperado, após a normalização. Um documento é “perfeito” quando todos os seus campos estão corretos. Os três modelos recebem a mesma instrução, com temperatura 0 (a configuração que torna as respostas mais estáveis), via vLLM 26.09, 16 documentos por vez. No Qwen3-8B, a reflexão está desativada. No gpt-oss 120B, o esforço de raciocínio está configurado como “baixo”.
| Modelo | Campos corretos | Documentos perfeitos | Perfeitos, layouts conhecidos | Perfeitos, layouts novos | Duração para 200 documentos |
|---|---|---|---|---|---|
| Qwen3-8B sem treinamento | 84,8 % | 26,0 % | 27 % | 25 % | 686 s |
| gpt-oss 120B sem treinamento | 97,5 % | 62,5 % | 58 % | 67 % | 991 s |
| Qwen3-8B + LoRA (85 min) | 99,2 % | 95,0 % | 96 % | 94 % | 524 s |
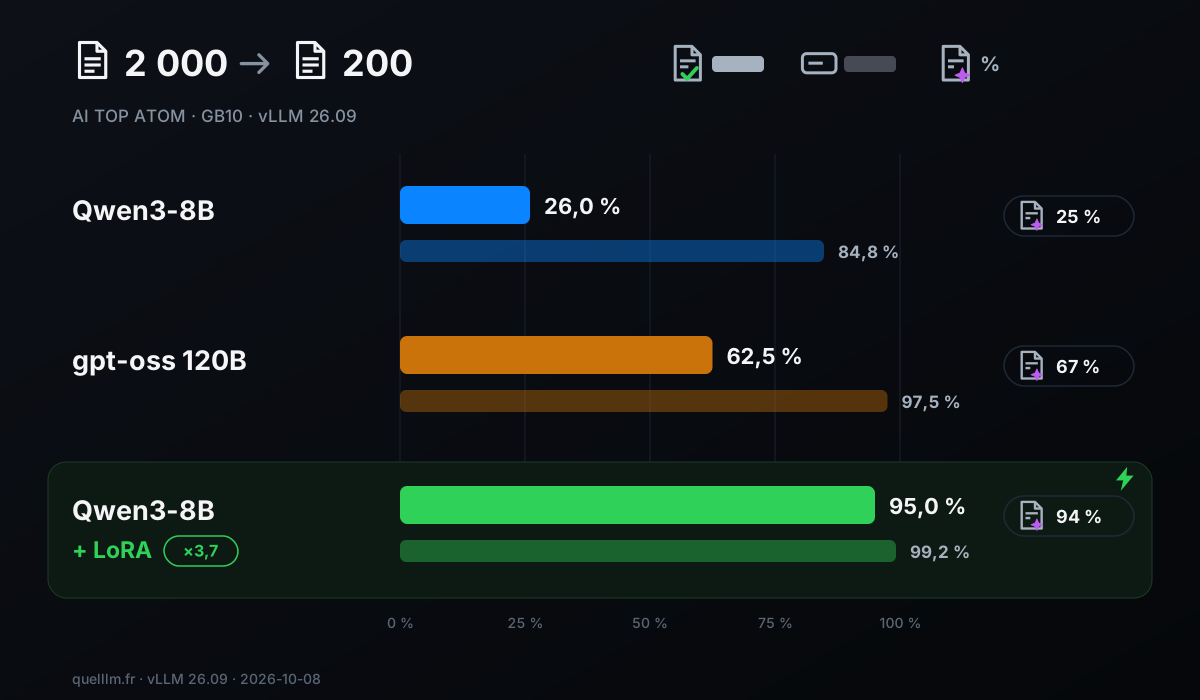
O modelo treinado alcança 95,0% de documentos perfeitos, contra 26,0% do mesmo modelo sem treinamento: 69 pontos a mais, ou seja, 3,7 vezes mais documentos sem erro. Ele supera o gpt-oss 120B (62,5%), um modelo de 117 bilhões de parâmetros. Também é o mais rápido: 524 segundos para os 200 documentos, contra 991 segundos do gpt-oss 120B e 686 segundos do Qwen3-8B sem treinamento. Suas respostas também são mais curtas: 98.847 tokens escritos, contra 160.702 do gpt-oss 120B.
Nos 100 documentos com layouts nunca vistos, o modelo treinado mantém 94% de documentos perfeitos e 98,5% de campos corretos, contra 96% e 99,9% nos layouts conhecidos. A diferença é de 2 pontos nos documentos perfeitos (96% contra 94%): o adaptador não se limita aos formatos vistos durante o treinamento.
O detalhamento por campo mostra o que o treinamento corrigiu. Os 31 campos estão todos corretos em pelo menos 97,5% dos documentos, e 18 deles em 100% dos documentos. Sem treinamento, 10 campos ficam corretos entre 49,5% e 61,5% das vezes: os valores (desconto, totais, TVA, adiantamento, valor líquido a pagar) e as linhas (quantidade, preço unitário, alíquota de TVA, valor). Após o treinamento, esses 10 campos ficam corretos de 98% a 100% das vezes.
Os três modelos retornam um JSON válido em 100% dos casos e encontram o número correto de linhas em 100% dos documentos. A diferença está, portanto, no valor dos campos, não no formato da resposta.
#Quanto isso custa: tempo, memória, eletricidade
| Medição | Valor |
|---|---|
| Duração do treinamento | 5.090 s, ou seja, 85 min (10,2 s por passo) |
| Pico de memória da GPU registrado pelo PyTorch | 33,3 GB |
| Potência da GPU, média e pico | 53,0 W e 62,7 W |
| Temperatura da GPU, média e máxima | 65 °C e 77 °C |
| Throttling informado pela GPU | nenhum nas 5.206 medições |
| Energia da GPU no treinamento (87 minutos de medição, incluindo o carregamento) | 76,7 Wh |
| Custo pela tarifa EDF Tarif Bleu Base (20,01 centavos de euro por kWh, com impostos – TTC) | 1,5 centavo de euro |
| Energia da GPU para ler os 200 documentos de teste com o modelo treinado | cerca de 6 Wh |
Estes números se referem apenas à GPU, conforme informado pelo próprio chip. Segundo NVIDIA, a potência exibida pelo nvidia-smi é a da GPU sozinha. O processador, a memória, o SSD e a fonte de alimentação não são contabilizados. A tarifa é a da opção Base da EDF para 6 kVA, na tabela vigente em 1º de agosto de 2026; a assinatura não está incluída.
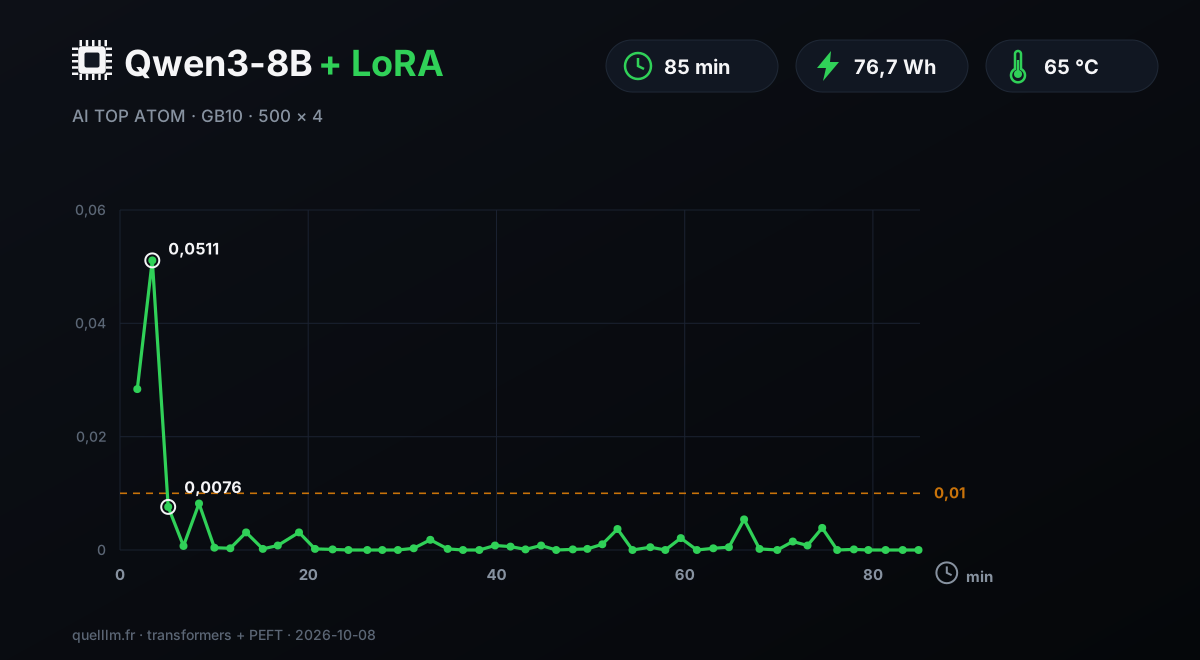
Cada ponto da curva vem de um único lote de 4 documentos: por isso, os valores variam de uma leitura para outra. A perda fica abaixo de 0,01 já no passo 30, após 5 minutos de treinamento, e nenhuma leitura seguinte passa de 0,0082. Uma única época bastou para chegar a 95% de documentos perfeitos neste caso.
#QLoRA com Unsloth: um 70B e gpt-oss 120B na mesma máquina
O QLoRA comprime os pesos do modelo em 4 bits, o que reduz bastante o espaço que ele ocupa na memória, e depois treina um adaptador LoRA sobre ele. É o caminho para especializar um modelo grande sem trocar de máquina. Usamos o Unsloth, uma ferramenta livre que, segundo seu desenvolvedor, torna o fine-tuning mais leve e mais rápido.
NVIDIA publica um guia oficial para o Unsloth no DGX Spark, em um contêiner PyTorch de NVIDIA (versão 25.11), e também oferece um ambiente oficial de fine-tuning com PyTorch para modelos de 1 a 70 bilhões de parâmetros. O Unsloth informa cerca de 68 GB de memória para um QLoRA de 4 bits do gpt-oss 120B; nossa medição foi de 64,4 GB de pico, da mesma ordem de grandeza.
Medimos a velocidade e a memória em dois modelos: Llama 3.3 70B e gpt-oss 120B, ambos no formato de 4 bits publicado pelo Unsloth. Cada teste tem 40 etapas, e as 10 primeiras, que servem para a inicialização, não entram na média.
As sequências têm 1.024 tokens, com lote de 1 e um LoRA de rank 16. Essas etapas, feitas com o texto de referência do nosso protocolo, medem o throughput e a memória; elas não produzem um modelo útil.
| Modelo | Chargement | Memória do modelo | Pico de memória da GPU | Segundos por etapa | Tokens por segundo | Parâmetros treinados |
|---|---|---|---|---|---|---|
| Llama 3.3 70B (QLoRA de 4 bits) | 247 s | 37,6 GB | 41,3 GB | 9,39 | 109 | 207 milhões (7 projeções) |
| gpt-oss 120B (QLoRA de 4 bits) | 397 s | 58,5 GB | 64,4 GB | 6,35 | 161 | 11,9 milhões (4 projeções de atenção) |
| Qwen3-8B (LoRA bf16) | — | — | 63,4 GB | 5,42 | 756 | 43,6 milhões (7 projeções) |
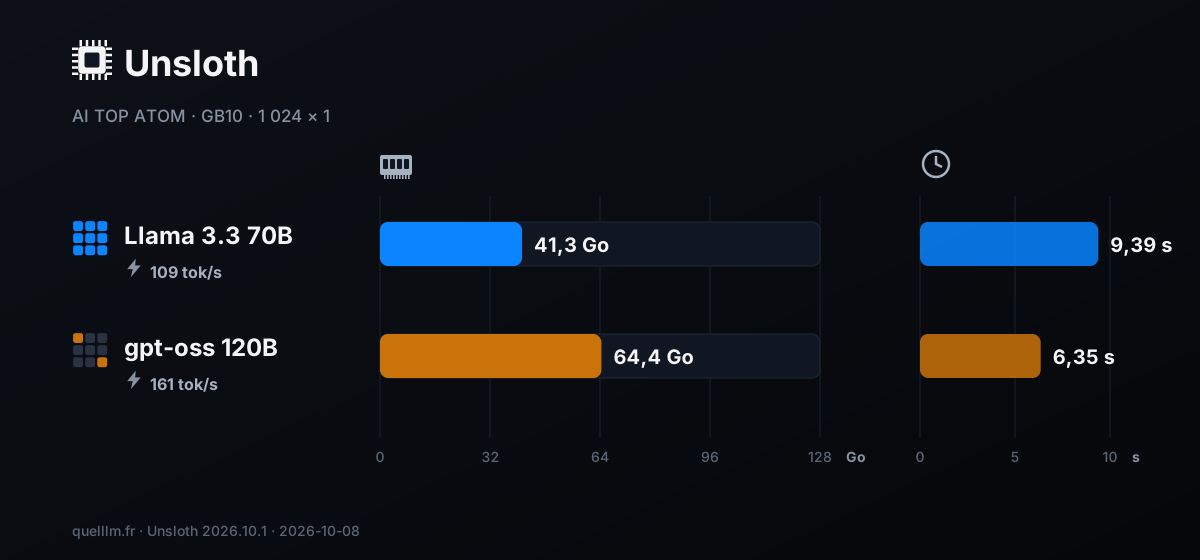
O 70B é treinado com 41,3 GB de pico, cerca de um terço dos 121,7 GB que o sistema enxerga; o gpt-oss 120B exige 64,4 GB. Nos dois casos, ainda sobra espaço para outros serviços. Um fato notável: o gpt-oss 120B avança mais rápido por etapa que o 70B (6,35 s contra 9,39 s), embora seja maior.
É um modelo MoE, uma “mistura de especialistas”: a cada token, ele usa apenas 5,1 de seus 117 bilhões de parâmetros. Nele, treinamos apenas as 4 matrizes da atenção (q, k, v, o), ou seja, 11,9 milhões de parâmetros. O 70B recebe um LoRA em suas 7 projeções, ou seja, 207 milhões de parâmetros treinados.
Para planejar, aqui está um cálculo feito a partir das nossas medições. 1 000 etapas de 1 024 tokens, ou seja, cerca de um milhão de tokens, levariam 2 h 36 min com o 70B e 1 h 46 min com gpt-oss 120B. Verifique essas durações no seu conjunto de dados. O QLoRA do 70B ocupou a GPU por 10,8 minutos, incluindo o carregamento do modelo, com 8,9 Wh no lado da GPU.
O Unsloth 2026.10.1 é instalado no mesmo ambiente Python descrito acima, no mesmo contêiner PyTorch. Para a instalação passo a passo, siga o guia oficial de NVIDIA e a documentação do Unsloth, com links no fim da página.
#Servir o modelo treinado com vLLM
O vLLM é um servidor livre, projetado para atender várias pessoas ao mesmo tempo; nós o usamos no contêiner fornecido pela NVIDIA. Ele carrega o modelo original e depois adiciona o adaptador. A API então expõe dois nomes: Qwen3-8B, sem adaptador, e factures, com o adaptador. Avaliamos os dois no mesmo servidor, o que torna a comparação justa.
Com 16 documentos enviados de uma vez, as 200 faturas são processadas em 524 segundos. Nesse ritmo, 1.000 faturas levam cerca de 44 minutos: é um cálculo feito a partir da nossa medição. A porta está vinculada ao endereço local 127.0.0.1. Para abrir o serviço para a sua rede, adicione uma chave de API; o guia sobre vLLM em produção detalha essa etapa.
#Reproduza este caso no seu ambiente em cinco etapas
- 01Prepare os exemplosReúna pares: o texto de um documento e a resposta JSON esperada. Escreva um único prompt, o mesmo para o treinamento e para a avaliação. Usamos 2.000 exemplos; não medimos um limite mínimo.
- 02Reserve um conjunto de testeSepare alguns documentos sem nunca mostrá-los ao modelo. Inclua também alguns layouts ausentes do treinamento, para saber se o modelo generaliza.
- 03Treine uma épocaOrdene os exemplos por comprimento, monte os lotes, calcule a perda apenas sobre a resposta e acompanhe a curva de perda.
- 04Avalie antes e depoisDê notas ao modelo original e ao modelo treinado com o mesmo prompt, campo por campo. Avalie também um modelo grande sem treinamento: essa é a comparação mais útil.
- 05Sirva com o vLLMCarregue o adaptador com a opção enable-lora e conecte o seu software à API.
#Fine-tuning, RAG ou um prompt melhor: qual escolher?
Comece pelo prompt: é gratuito e imediato. Se o modelo precisar encontrar fatos nos seus documentos, um RAG é mais adequado: trata-se de um assistente que primeiro faz a busca nos seus arquivos e só depois responde.
O fine-tuning é a ferramenta certa quando a tarefa se repete, o formato de saída precisa permanecer estável e você tem exemplos. A leitura de faturas atende a essas três condições. As duas abordagens podem ser combinadas na mesma máquina; outro guia da série mostra um assistente RAG completo.
#Os limites das nossas medições
- Documentos fictícios
- Nossas faturas são geradas por um script, com 12 layouts. Documentos reais, digitalizados ou fotografados, exigem primeiro uma leitura do texto (OCR) e podem dar outros resultados.
- Um único treinamento
- Treinamos um único adaptador e avaliamos cada modelo uma vez, com temperatura 0. Não medimos a variação de um treinamento para outro nem comparamos com um treinamento mais longo.
- gpt-oss 120B
- Ele é avaliado com esforço de raciocínio baixo. Outra configuração pode mudar sua pontuação.
- QLoRA
- As medições de QLoRA tratam da velocidade e da memória, em 40 etapas. Não avaliamos a qualidade de modelos 70B ou 120B treinados.
- Energia
- Ela se refere apenas à GPU.
- Fora do escopo
- Não medimos o treinamento de todos os parâmetros de um modelo nem o uso de várias máquinas conectadas.
Atualizações e correções: esta página será revisada se uma nova versão do Unsloth, do vLLM ou do DGX OS alterar estes resultados; cada correção será datada.
#Para quem o ATOM é a escolha certa
- Uma pequena ou média empresa ou um escritório que quer especializar um modelo pequeno em seus documentos
- 85 minutos e 1,5 centavo de euro de eletricidade na GPU para passar de 26% a 95% de faturas perfeitas em nosso conjunto de faturas fictícias, sem enviar um único documento a terceiros.
- Um desenvolvedor ou uma equipe de dados que constrói protótipos
- Qwen3-8B em LoRA, um 70B ou gpt-oss 120B em QLoRA: os três cabem na mesma máquina, com pico de 33 a 64 GB de memória da GPU.
- Uma equipe que quer treinar, avaliar e servir no mesmo lugar
- A mesma máquina treinou o adaptador, avaliou três modelos e serviu as respostas com vLLM.
- Um escritório sem sala de servidores
- Um gabinete de um litro (150 × 150 × 50,5 mm, 1,2 kg) alimentado por um adaptador USB-C de 240 W.
Vamos separar a plataforma e o fabricante. O chip NVIDIA GB10, seus 128 GB de memória unificada a 273 GB/s, CUDA e DGX OS 7.5.0 determinam a maior parte das velocidades de treinamento. Em inferência, nossas medições ficam no máximo a 4,3% das publicadas para o DGX Spark; os treinamentos deste guia foram realizados na AI TOP ATOM.
A GIGABYTE fornece o chassi e sua refrigeração com duas ventoinhas. Durante os 87 minutos de registro do treinamento, com média de 53 W na GPU, a temperatura ficou em 65 °C em média e 77 °C no máximo, sem nenhum throttling sinalizado.
Preços verificados em 8 de outubro de 2026 para a ATAGB10-9001 (128 GB, SSD de 4 TB em PCIe 4.0): 6.346,27 € com impostos (TTC) na loja oficial da AORUS, onde estava esgotada; ela estava em estoque na Amazon.fr. Medimos o modelo ATAGB10-9000, cujo SSD é PCIe 5.0. Os preços das GB10 mudam toda semana: confira antes de comprar.
#FAQ
Quanto tempo leva para fazer fine-tuning de um modelo de 8 bilhões de parâmetros em um GB10?+
É possível fazer fine-tuning de um modelo 70B ou gpt-oss 120B com 128 GB?+
Um modelo pequeno treinado pode mesmo superar um modelo grande?+
Quanto custa a eletricidade de um fine-tuning?+
Como usar o adaptador depois que o treinamento terminar?+
É preciso ter a versão de 128 GB do ATOM para fazer fine-tuning?+
Um comentário, um erro ou uma observação? Avise-nos; isso ajuda a melhorar o guia para todos.