LLM 70B local no GB10: o tutorial complet
Em um GIGABYTE AI TOP ATOM (chip NVIDIA GB10, 128 GB), o Llama 3.3 70B cabe com folga: 43,6 GB com um contexto de 8 192 tokens, 82 GB com 131 072. Ele gera entre 4,6 e 5,3 tokens por segundo por três caminhos: Ollama, llama.cpp ou vLLM. Um modelo de rascunho Llama 3.2 1B leva o llama.cpp a 12 tokens por segundo em prosa e 19 em código. Com oito usuários, o vLLM sustenta 38,6 tokens por segundo no total, em média, durante duas horas.
Um modelo de 70 bilhões de parâmetros como o Llama 3.3 70B é “denso”: ele usa todos os seus parâmetros para escrever cada palavra e precisa de muita memória. Os 128 GB de uma máquina GB10 o comportam com folga. Este tutorial traz os comandos de três formas de instalá-lo, testadas em um AI TOP ATOM cedido gratuitamente pela GIGABYTE, e depois as medições que ajudam a escolher: velocidade, pequeno modelo de rascunho, memória do contexto, estabilidade ao longo de duas horas e atendimento a vários usuários.
#A máquina, o método e as unidades
Primeiro, um pouco de vocabulário. Um token é um pedaço de palavra: em francês, um token equivale a cerca de dois terços de palavra. O contexto é o texto que o modelo mantém na memória durante uma interação: suas perguntas, seus documentos e as respostas dele. A velocidade de geração é o ritmo em que a resposta aparece, em tokens por segundo (tok/s). A velocidade de leitura é o ritmo em que a máquina processa seu texto antes de responder.
A máquina é um GIGABYTE AI TOP ATOM, modelo ATAGB10-9000. Seu chip NVIDIA GB10 reúne 20 núcleos Arm e uma GPU Blackwell, que compartilham 128 GB de memória a 273 GB/s. O SSD tem 4 TB em PCIe 5.0. Ela roda DGX OS 7.5.0, o sistema da NVIDIA baseado em Ubuntu (driver 580.159.03, CUDA 13.0). O sistema enxerga 121,7 GB de memória.
- O que vem da plataforma NVIDIA GB10
- O chip, seus 128 GB a 273 GB/s e o DGX OS determinam as velocidades deste guia. Ao reproduzir duas referências publicadas para o DGX Spark da NVIDIA, com llama.cpp e com Ollama, nossas velocidades ficam a no máximo 4,3 % de diferença. Até onde sabemos, elas devem portanto valer para as outras máquinas GB10 de 128 GB. As medições deste guia foram feitas no AI TOP ATOM.
- O que vem da GIGABYTE
- O gabinete de cerca de um litro e seu resfriamento, o acabamento, as versões (a 9000 traz um SSD de 4 TB em PCIe 5.0) e a garantia do revendedor. Durante nossas duas horas de serviço contínuo, a GPU não passou de 72 °C e não houve nenhum throttling.
As medições foram feitas em 6 e 7 de outubro de 2026 (as do assistente privado com Open WebUI, em 7 e 8 de outubro). O protocolo foi congelado em 6 de outubro às 13h30, antes da primeira medição. Adendos datados, redigidos antes dos testes que descrevem, acrescentaram a decodificação especulativa e o orçamento de memória. O método e os dados das nossas tabelas estão publicados na nossa página de metodologia.
As velocidades de escrita do llama.cpp e do TensorRT-LLM vêm de seis textos de 400 tokens: três em prosa francesa e três pedidos de código. As do Ollama (um texto de 300 palavras) e do vLLM (requisições aleatórias de 1 024 tokens de entrada e 256 de saída) seguem os protocolos descritos em suas seções. A temperatura é fixada em 0: o modelo sempre escolhe a palavra mais provável, o que torna os testes comparáveis. Publicamos a mediana dos três textos de cada tipo.
Os tamanhos de memória estão em GB (1 GB = 1.024 MB, como o Linux exibe); as taxas em GB/s são as anunciadas pelos fabricantes, em unidades decimais. As versões usadas são llama.cpp b11430 (build de 5 de outubro de 2026), Ollama 0.34.1, vLLM 26.09 e TensorRT-LLM 1.3.0rc12, estes dois últimos nos contêineres da NVIDIA. Nosso primeiro guia da série traz as medições de 13 modelos, incluindo o Llama 3.3 70B; este mostra como instalá-lo e acelerá-lo.
#Caminho 1: Ollama, o mais simples
Ollama é a forma mais simples de começar: um arquivo compactado para descompactar, um comando para baixar o modelo e outro para conversar com ele. Instalamos a versão 0.34.1 a partir do arquivo oficial para Linux Arm, em uma pasta e sem serviço do sistema. Se você preferir o instalador habitual, nosso guia de instalação no Linux o descreve.
A opção --verbose exibe as estatísticas no fim da resposta. No nosso caso, o Llama 3.3 70B (em Q4_K_M, uma compressão dos pesos) escreve a 4,97 tok/s na primeira execução e a 4,95 tok/s na segunda. O comando ollama ps indica 85 GB carregados, em unidades decimais: o Ollama abriu por conta própria um contexto de 131.072 tokens. Em um texto de 18.823 tokens, a leitura leva 55,6 s, ou seja, 338,7 tok/s, e a escrita seguinte fica em 4,38 tok/s.
Para situar esses números: o Ollama publica 4,423 tok/s para o Llama 3.1 70B Q4_K_M em um DGX Spark da NVIDIA (versão 0.12.6, 23 de outubro de 2025). Com a mesma versão, o mesmo script e o mesmo modelo (Llama 3.1 70B), nosso ATOM chega a 4,34 tok/s, uma diferença de 2 %. Para reduzir o contexto e a memória ocupada, defina a variável OLLAMA_CONTEXT_LENGTH antes de iniciar o servidor; não medimos essa variante.
#Opção 2: llama.cpp, a que oferece mais configurações
O llama.cpp é um motor open source muito difundido. Ele lê modelos no formato GGUF, um arquivo único que contém os pesos. É preciso compilá-lo uma vez para o chip GB10, mas ele dá acesso a todas as configurações: tamanho do contexto, formato do cache do contexto, modelo rascunho. A compilação segue o guia da NVIDIA, com a arquitetura CUDA 121a-real, a do GB10, mas sem libcurl (-DLLAMA_CURL=OFF) nem RPC.
O arquivo escolhido é o Llama 3.3 70B em Q4_K_M, publicado por bartowski: 39,6 GB. Com o cache de disco esvaziado, o llama.cpp o carrega em 8 s a partir do SSD. O comando hf vem da biblioteca huggingface_hub (instalação: pip install -U huggingface_hub). Se o Hugging Face pedir que você aceite a licença Llama, aceite-a no site e depois faça login com hf auth login.
- -ngl 99
- Coloca todas as camadas do modelo na GPU.
- -fa on
- Ativa o Flash Attention, que torna a leitura do contexto mais econômica.
- -lm dio
- Lê o arquivo por acesso direto ao disco, sem passar pelo cache do sistema (mmap). É o modo da tabela de referência publicada pelo projeto llama.cpp para o DGX Spark.
- -c 16384 -np 1
- Um contexto de 16 384 tokens para um único usuário. O contexto solicitado é compartilhado entre os usuários simultâneos.
- --host 127.0.0.1
- O servidor só pode ser acessado a partir da própria máquina.
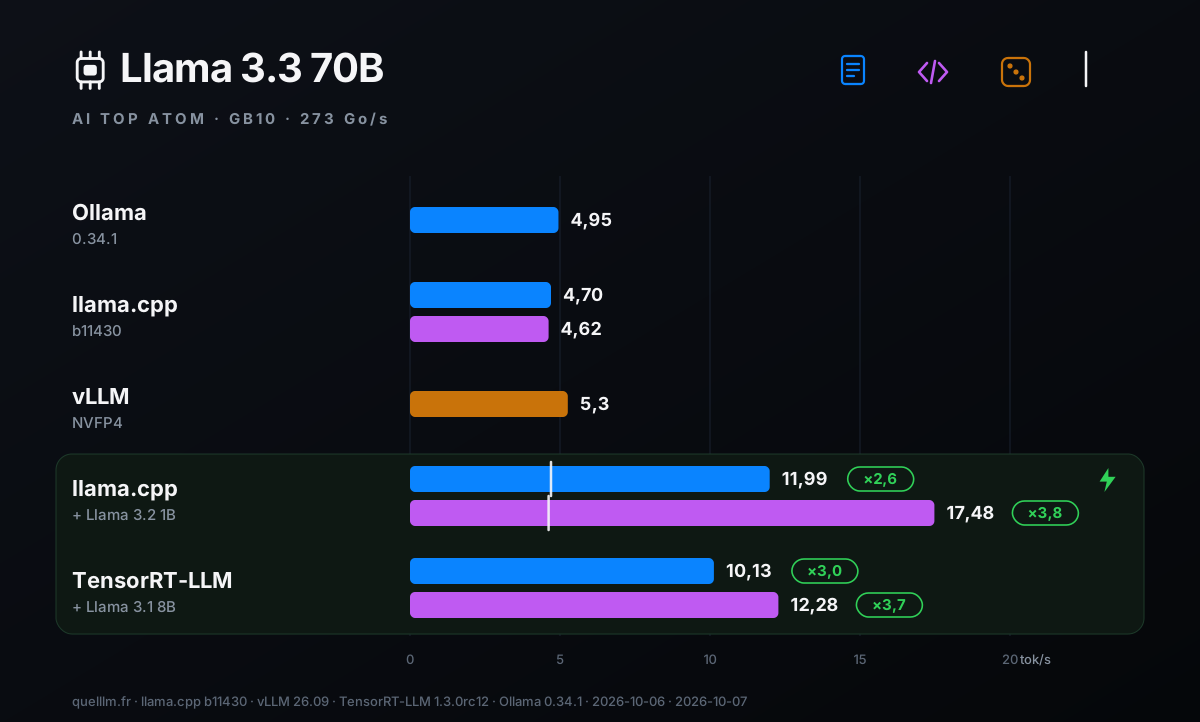
Em nossos seis textos, o llama-server gera a 4,70 tok/s em prosa e 4,62 em código. A ferramenta de medição llama-bench indica 4,8 tok/s na geração (32 tokens) e 405 tok/s na leitura (2 048 tokens). O modelo ocupa 43,6 GB com um contexto de 8 192 tokens.
Como referência, a memória lê no máximo 273 bilhões de bytes por segundo, e cada token exige reler os pesos do modelo, ou seja, 42,5 bilhões de bytes: o máximo teórico é de 6,4 tok/s, e a medição atinge cerca de três quartos disso.
#Via 3: vLLM em NVFP4, para vários usuários
O vLLM é um servidor projetado para atender várias pessoas ao mesmo tempo. A NVIDIA o fornece em um contêiner, ou seja, um programa isolado executado pelo Docker. O modelo é o Llama 3.3 70B em NVFP4, um formato de 4 bits da NVIDIA que os chips Blackwell processam diretamente: ele ocupa 39,9 GB de memória. A matriz de modelos compatíveis do guia vLLM da NVIDIA para o DGX Spark inclui esse modelo.
As configurações --max-model-len 8192 e --max-num-seqs 16 limitam o contexto a 8.192 tokens e a 16 requisições processadas ao mesmo tempo. A configuração --gpu-memory-utilization 0.85 define a parcela de memória que o vLLM reserva: aqui, 103 GB, dos quais 59,6 GB de cache. Esse cache comporta ao mesmo tempo 390.352 tokens, o equivalente a quase 48 requisições de 8.192 tokens simultâneas. A primeira inicialização leva cerca de 7 minutos: 4 min 20 s para ler o modelo e depois cerca de 2 minutos de preparação.
Para um usuário, o vLLM gera 5,3 tok/s (5,26, 5,27 e 5,26 em três séries) e a primeira palavra chega em 0,73 s em média. Com oito usuários simultâneos, a máquina gera 37,7 tok/s no total, incluindo a espera pela primeira palavra; depois que a resposta começa, cada usuário recebe 5,0 tok/s.
A primeira palavra chega em 2,8 s em média e em menos de 4,8 s nos casos mais lentos. As requisições deste teste têm 1.024 tokens de entrada e 256 de saída; cada ponto é medido três vezes.
#As três opções lado a lado
| Via | Geração | Memória | Configurações | Escolher para |
|---|---|---|---|---|
| Ollama 0.34.1 (Q4_K_M) | 4,95 | 85 GB exibidos pelo Ollama (em unidades decimais, ou seja, cerca de 79 GB no sentido deste guia) com o contexto de 131 072 tokens que ele abre sem ajustes | peu | começar rápido |
| llama.cpp b11430 (Q4_K_M) | 4,70 em prosa, 4,62 em código | 43,6 GB com 8.192 tokens, 51,3 GB com 32.768 | todos: contexto, cache, rascunho | um usuário, com um rascunho |
| vLLM 26.09 (NVFP4) | 5,3; 37,7 no total para 8 usuários | 103 GB reservados com a configuração 0,85 | os de um servidor | vários usuários |
As três formas geram texto na mesma velocidade, com diferença inferior a 15 %. O motivo é simples: para cada token, o chip relê os pesos do modelo, e é a largura de banda de 273 GB/s que dita o ritmo de um modelo denso. Um 70B gera, portanto, cerca de 5 tok/s, ou seja, cerca de 200 palavras por minuto, o ritmo de uma leitura tranquila.
Esse ritmo serve para processamentos sem pressa: resumos, extrações, revisões, rascunhos de respostas. Para uma conversa fluida, existem duas alavancas, apresentadas nas seções seguintes: o modelo de rascunho e um modelo MoE (mixture of experts), que usa apenas parte dos seus parâmetros a cada token.
#Acelerar um 70B com um pequeno modelo de rascunho
A decodificação especulativa usa um modelo pequeno, o rascunho, que propõe várias palavras à frente (mais exatamente tokens; dizemos "palavras" para simplificar). O modelo grande verifica essas palavras em uma única passada: isso custa mais ou menos o tempo de escrever uma só, porque o tempo é gasto sobretudo na leitura dos pesos.
As palavras corretas são mantidas, as outras são descartadas. O rascunho não escolhe o texto: é sempre o modelo grande que valida. A NVIDIA descreve o princípio no seu guia para o DGX Spark, e o blog da LMSYS observa que essa técnica reduz em parte a limitação de largura de banda da máquina.
#Com o llama.cpp: um rascunho Llama 3.2 1B
O modelo de rascunho deve falar a mesma língua que o modelo grande, ou seja, usar a mesma tokenização. A família Llama serve: o Llama 3.2 1B, em Q8_0, acompanha o Llama 3.3 70B. Quatro opções bastam: -md indica o rascunho, --spec-type draft-simple escolhe o método, --spec-draft-n-max define o número de tokens propostos antecipadamente (neste guia, nós os chamamos de "palavras") e -ngld 99 coloca o rascunho na GPU.
| Configuração | Prosa em francês | Código | Aceitação (prosa / código) |
|---|---|---|---|
| Só o 70B | 4,70 | 4,62 | — |
| + rascunho Llama 3.2 1B, 8 palavras de antecipação | 11,99 (×2,6) | 17,48 (×3,8) | 33 % / 50 % |
| + rascunho Llama 3.2 1B, 16 palavras à frente | 10,84 (×2,3) | 18,65 (×4,0) | 19 % / 34 % |
O modelo de rascunho de 1 bilhão de parâmetros torna o 70B de 2,6 a 4 vezes mais rápido: 12 tok/s em prosa e até 19 tok/s em código. O ganho depende do texto. Em três textos de código, a velocidade vai de 13,2 a 18,0 tok/s com 8 palavras antecipadas. O rascunho é aceito com mais frequência em código (50 % das palavras mantidas) do que em prosa (33 %).
Nossos textos estão em francês para a prosa e em inglês para o código; outros textos darão outros ganhos. Para a prosa, 8 palavras antecipadas rendem mais do que 16 (11,99 contra 10,84). Para o código, 16 rendem um pouco mais (18,65 contra 17,48), com uma variação entre textos da mesma ordem. Comece com 8.
O mesmo princípio existe sem um segundo arquivo quando o modelo traz seu próprio módulo de predição de múltiplos tokens (MTP). Com o Qwen3.8 27B e a opção --spec-type draft-mtp, o llama.cpp passa de 11,71 para 21,48 tok/s em prosa (×1,8) e de 11,59 para 27,23 tok/s em código (×2,3).
#Com TensorRT-LLM: a receita Draft-Target de NVIDIA
O TensorRT-LLM é a biblioteca da NVIDIA para servir modelos de forma otimizada. O guia dela para o DGX Spark propõe o método Draft-Target: o Llama 3.3 70B em FP4 é acompanhado do Llama 3.1 8B em FP4 como rascunho. Os dois modelos são fornecidos pela NVIDIA. Na versão 1.3.0rc12 do contêiner, o valor da configuração é escrito Draft_Target, com sublinhado.
| Configuração | Prosa em francês | Código |
|---|---|---|
| + rascunho Llama 3.1 8B FP4, 4 palavras à frente | 10,13 (×3,0 em relação ao mesmo motor sem rascunho) | 12,28 (×3,7) |
Com o TensorRT-LLM, o rascunho multiplica a velocidade por 3,0 em prosa e por 3,7 em código, em relação ao mesmo motor sem rascunho: o 70B passa então a escrever 10,1 tokens por segundo em prosa e 12,3 em código.
As duas vias, llama.cpp e TensorRT-LLM, trazem, portanto, um ganho da mesma ordem, de 2,6 a 4 vezes. Para um único usuário, o llama.cpp continua sendo a mais simples: um arquivo de modelo de rascunho e quatro opções. O TensorRT-LLM é o caminho a seguir se você quiser a receita oficial de NVIDIA, com modelos FP4 fornecidos por NVIDIA.
#O orçamento de memória do contexto, de 8.192 a 131.072 tokens
O contexto tem um custo em memória: o cache KV. É a memória em que o modelo guarda o que já leu, para não precisar recalcular. Ele cresce com o tamanho do contexto. O llama.cpp reserva todo esse cache já no carregamento, então a memória ocupada após o carregamento já é a memória final.
Nós a medimos pela queda da memória disponível (MemAvailable do Linux), depois de esvaziar o cache de disco. A opção -ctk q8_0 -ctv q8_0 armazena o cache em 8 bits em vez de 16 (f16), o que o deixa mais leve. Nas tabelas e nos gráficos, 8k designa um contexto de 8.192 tokens, 32k de 32.768, 64k de 65.536 e 128k de 131.072.
| Modelo | Cache | 8 192 | 32 768 | 65 536 | 131 072 |
|---|---|---|---|---|---|
| Llama 3.3 70B Q4_K_M | f16 | 43,6 | 51,3 | 61,4 | 81,9 |
| Llama 3.3 70B Q4_K_M | q8_0 | 42,3 | 46,4 | 52,2 | 63,1 |
| gpt-oss 120B MXFP4 | f16 | 61,0 | 61,9 | 63,0 | 65,6 |
| gpt-oss 120B MXFP4 | q8_0 | 60,7 | 61,3 | 62,1 | 63,2 |
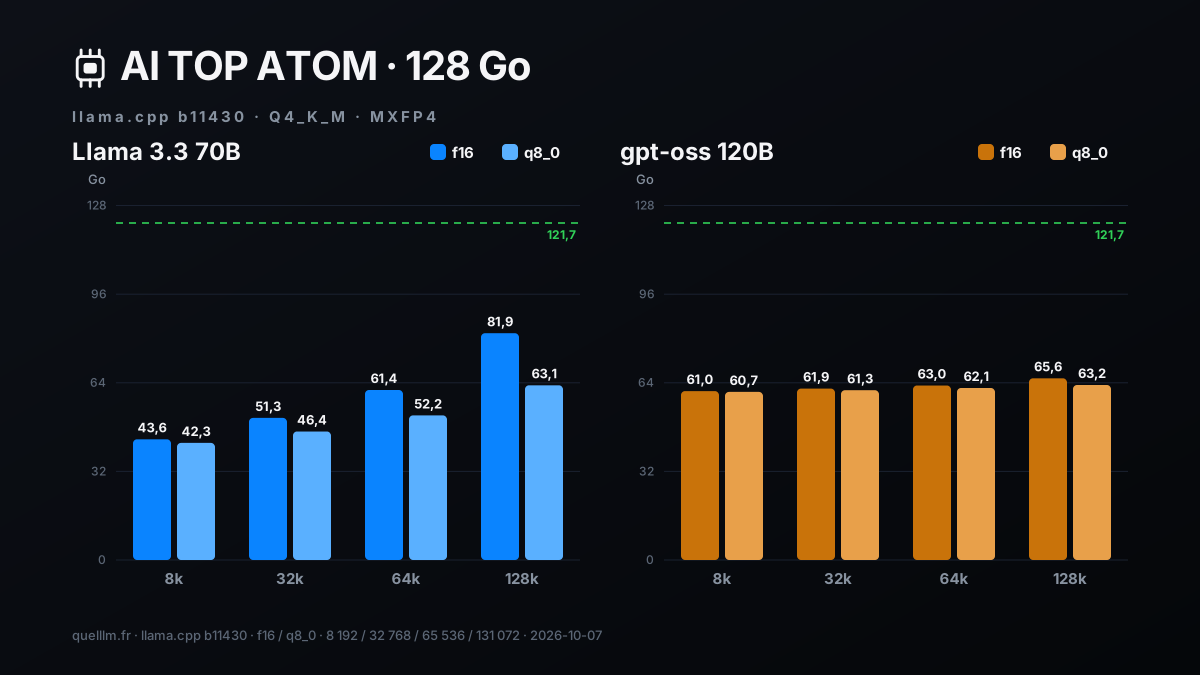
Tudo cabe nos 121,7 GB, até o 70B com um contexto de 131.072 tokens em f16: 81,9 GB. O contexto acrescenta 38 GB ao 70B entre 8k e 128k em f16, e 21 GB em q8_0, ou seja, quase metade. O gpt-oss 120B acrescenta só 4,6 GB: ele alterna camadas que olham o texto inteiro e camadas que olham só uma janela curta. O formato q8_0 cobra seu preço com uma velocidade um pouco menor, de 9 a 11% em 128k para o 70B (tabela a seguir).
Também preenchemos o contexto até 90 % com fichas práticas do Service-Public, para medir a leitura e a geração com contexto cheio. A 128k, o texto tem 117 605 tokens para o 70B e 117 889 para o gpt-oss 120B, ou seja, cerca de 200 páginas.
| Modelo | Cache | Texto lido (tokens) | Memória (GB) | Lecture | Geração |
|---|---|---|---|---|---|
| Llama 3.3 70B | f16 | 29 214 (32k) | 51,4 | 286,1 (102 s) | 4,22 |
| Llama 3.3 70B | q8_0 | 29 214 (32k) | 46,5 | 271,1 (108 s) | 4,02 |
| Llama 3.3 70B | f16 | 117 605 (128k) | 82,0 | 181,9 (646 s) | 2,86 |
| Llama 3.3 70B | q8_0 | 117 605 (128k) | 63,2 | 164,6 (715 s) | 2,54 |
| gpt-oss 120B | f16 | 29 227 (32k) | 61,7 | 1 443 (20 s) | 43,81 |
| gpt-oss 120B | q8_0 | 29 227 (32k) | 61,2 | 1 401 (21 s) | 43,96 |
| gpt-oss 120B | f16 | 117 889 (128k) | 65,4 | 1 073 (110 s) | 26,93 |
| gpt-oss 120B | q8_0 | 117 889 (128k) | 63,4 | 993 (119 s) | 24,97 |
Tudo funciona com o contexto cheio. O gpt-oss 120B lê um texto de 200 páginas em 110 segundos e continua gerando a quase 27 tok/s. O 70B lê os 117 605 tokens a 182 tok/s. Para documentos muito longos, um modelo MoE é mais rápido, tanto na leitura quanto na geração.
#Duas horas de serviço para oito usuários
Um servidor precisa aguentar ao longo do tempo. Executamos o vLLM 26.09 com o Llama 3.3 70B em NVFP4 e enviamos requisições durante duas horas: oito usuários contínuos, em lotes de 32 requisições com 1.024 tokens de entrada e 256 de saída. Uma leitura do chip, com uma medição por segundo, acompanhou a potência, a frequência e a temperatura da GPU.
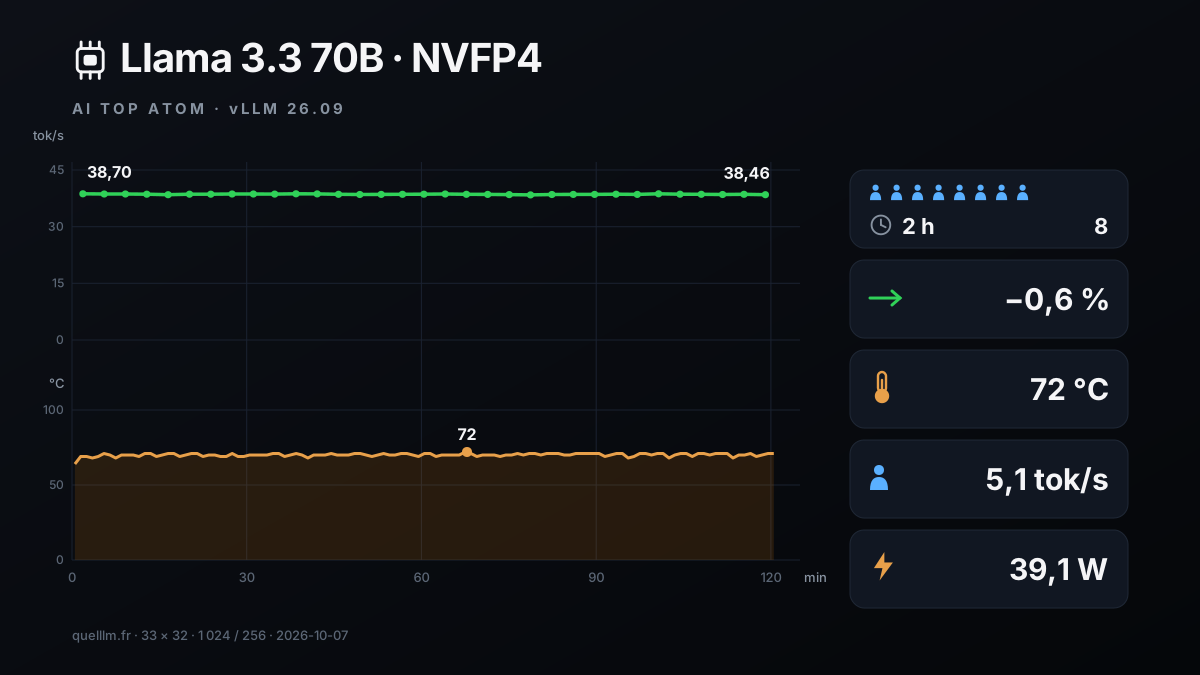
O resultado é simples: a velocidade não mudou. A vazão total vai de 38,70 tok/s no primeiro intervalo a 38,46 no último, com mínimo de 38,40 e máximo de 38,70: a diferença é de −0,6%. Cada usuário recebe 5,1 tok/s. A primeira palavra chega em 2,8 s na mediana, entre 2,4 e 2,9 s conforme o intervalo.
No total, a máquina atendeu 1 056 requisições, leu 1 081 344 tokens e escreveu 270 336 tokens, sem nenhum erro. A GPU ficou em no máximo 72 °C. Sua frequência mediana foi de 2 528 MHz e nenhum motivo de throttling foi registrado durante as duas horas de monitoramento.
A potência média da GPU foi de 39,1 W, com pico de 95,0 W. Esses watts são os da GPU, lidos pelo chip: não incluem o processador, nem a memória, nem o SSD, nem a fonte de alimentação. As duas horas representam 78,8 Wh para a GPU, ou seja, 1,6 centavo de euro pela tarifa EDF Tarif Bleu Base (6 kVA), a 20,01 centavos de euro por kWh.
#Transformá-lo em servidor: API OpenAI, chave e Open WebUI
Uma API OpenAI é um formato de requisições que muitas ferramentas sabem usar: editores de código, interfaces de chat, scripts. O llama-server e o vLLM oferecem esse formato. Para protegê-la, o llama-server aceita uma chave com a opção --api-key: sem a chave, ele responde com um erro 401. Validamos essas três chamadas com gpt-oss 20B; para o 70B, é o mesmo comando com outro arquivo.
A primeira chamada retorna 401, a segunda, a lista dos modelos servidos, e a terceira, uma resposta no formato da OpenAI. A opção --jinja aplica o template de conversa fornecido pelo arquivo do modelo.
Para uma interface de chat, o Open WebUI se conecta a essa API. Veja a stack do nosso teste de assistente privado (outro guia da série), com gpt-oss 120B. O servidor do modelo fica em uma rede Docker interna, sem acesso à Internet. O Open WebUI 0.11.4 está conectado a essa rede e a uma rede de acesso.
Assim, o modelo não tem nenhuma saída para o exterior. O servidor não tem chave, porque só a rede interna consegue acessá-lo; o valor local de OPENAI_API_KEY serve apenas para satisfazer o Open WebUI. Para servir o 70B no lugar dele, substitua o caminho do arquivo pelo de Llama-3.3-70B-Instruct-Q4_K_M.gguf e ajuste -c e -np ao orçamento de memória visto acima.
Em seguida, abra http://127.0.0.1:3100 em um navegador da máquina: o modelo aparece na lista. No nosso teste de assistente privado, a pilha completa, com um servidor de embeddings (bge-m3) a mais, ficou pronta em 66 segundos. Segundo o guia do llama.cpp de NVIDIA, Open WebUI, Continue.dev e outros clientes se conectam a essa API, que segue o formato da API da OpenAI (endereço do servidor seguido de /v1).
#A alternativa rápida: um modelo MoE de 120B
Um modelo MoE (mixture of experts) contém muitos parâmetros, mas usa apenas uma fração deles a cada token. O gpt-oss 120B tem 117 bilhões de parâmetros, dos quais 5,1 bilhões ativos, e a OpenAI o publica diretamente no formato MXFP4.
Na GB10, ele gera a 58,0 tok/s com a ferramenta de medição llama-bench (geração de 32 tokens) e a 54,4 tok/s em respostas longas no llama-server, tanto em prosa quanto em código. É mais de 11 vezes a velocidade do 70B denso, com memória ocupada de 61,0 GB a 8 192 tokens e de 65,6 GB a 131 072.
A velocidade não diz nada sobre a qualidade: não comparamos as respostas dos dois modelos. Veja como escolher. Use o gpt-oss 120B para conversa, agentes e documentos longos, em que a velocidade importa. Use o Llama 3.3 70B se você precisar desse modelo específico, por exemplo um modelo ajustado a partir dele, ou para processamentos em lote em que 5 tok/s bastam. As medições dos 13 modelos, do 4B ao 235B, estão no nosso primeiro guia da série.
#O que este guia não mede
- A qualidade das respostas
- Medimos a velocidade e a memória, não o quanto cada modelo vale.
- Os ganhos do rascunho em outros textos
- Nossos seis textos estão em francês na prosa e em inglês no código. Os ganhos dependem do texto e do idioma.
- Contextos acima de 131.072 tokens
- Não medimos nem a memória nem a velocidade deles.
- As outras máquinas GB10 e a versão de 64 GB
- Nossas medições no ATOM 128 GB batem com as referências publicadas para o DGX Spark.
- O consumo da máquina inteira
- Os watts informados são os da GPU, lidos pelo chip.
Atualizações e correções: esta página será revisada se uma nova versão do DGX OS, do llama.cpp, do Ollama, do vLLM ou do TensorRT-LLM alterar esses resultados; cada correção será datada.
#Para quem o ATOM é a escolha certa
O que vem a seguir é baseado nas nossas medições no ATOM, uma máquina GB10 de 128 GB.
- O ATOM é a escolha certa se você quer um modelo de 70 bilhões de parâmetros em casa
- Ele cabe com folga: de 43,6 a 82 GB de 121,7 GB, com um contexto de 8.192 a 131.072 tokens, e três formas de instalação funcionam.
- … se várias pessoas ou agentes compartilham o modelo
- Oito usuários obtêm 37,7 tok/s no total em uma série curta e 38,6 tok/s em média durante duas horas, sem nenhum erro.
- … se você quer ir mais rápido sem trocar de máquina
- Um pequeno modelo de rascunho multiplica a velocidade do 70B por 2,6 a 4, com llama.cpp ou com a receita de NVIDIA.
- … se você quer uma conversa rápida ou documentos longos
- gpt-oss 120B escreve a 54,4 tok/s e lê 200 páginas em 110 segundos.
- … se o seu trabalho passa pelo ecossistema NVIDIA
- CUDA 13, vLLM e TensorRT-LLM nos contêineres de NVIDIA e o llama.cpp compilado para o GB10 funcionaram em nossos testes no DGX OS 7.5.0.
Do lado da GIGABYTE, o gabinete de cerca de um litro manteve a GPU a no máximo 72 °C durante duas horas de carga contínua, sem throttling. Os preços das máquinas GB10 mudam toda semana: confira-os na página da máquina antes de comprar.
#FAQ
É possível rodar um modelo 70B em uma máquina GB10 de 128 GB?+
Com que velocidade um 70B gera texto no AI TOP ATOM?+
Devo escolher Ollama, llama.cpp ou vLLM?+
Como deixar um 70B mais rápido sem trocar de máquina?+
Um 70B consegue atender várias pessoas por horas?+
Vale mais a pena um modelo MoE de 120B do que um 70B denso?+
Um comentário, um erro ou uma observação? Avise-nos; isso ajuda a melhorar o guia para todos.