GB10, Ryzen AI Max+ 395 ou Mac: qual é o mais rápido?
Com o mesmo motor (llama.cpp), o AI TOP ATOM, com seu chip NVIDIA GB10, lê os prompts de 2,1 a 2,8 vezes mais rápido que o Ryzen AI Max+ 395 e 23% mais rápido que o Mac M5 Max no modelo de referência publicado. Na geração, ele fica no nível do Ryzen (de 4 a 15% à frente, dependendo do modelo). O Mac M5 Max gera cerca de duas vezes mais rápido em um pequeno modelo denso: 119,9 contra 59,4 tok/s (tokens por segundo).
Três famílias de máquinas oferecem 128 GB de memória para IA local: o GB10 da NVIDIA, do qual o AI TOP ATOM da GIGABYTE é uma versão, o Ryzen AI Max+ 395 da AMD (codinome Strix Halo) e o Mac M5 Max da Apple. Medimos o nosso AI TOP ATOM, cedido gentilmente pela GIGABYTE, com os mesmos comandos das medições publicadas para os outros dois, com versão do software e data documentadas. Veja onde cada um se destaca e qual compra combina com cada uso.
#Como comparamos três máquinas?
Para comparar as referências publicadas do Ryzen AI Max+ 395 e do Mac com as medições do ATOM, adotamos o formato exato de medições já publicadas. O primeiro teste faz a máquina ler 512 tokens (um token é um pedaço de palavra) e depois escrever 128 («pp512» e «tg128» no llama-bench, a ferramenta de medição do llama.cpp, um motor open source muito difundido para modelos locais).
Este teste foi publicado para um Mac M5 Max na discussão nº 4167 do llama.cpp e, por kyuz0, um colaborador independente, para um Framework Desktop equipado com o Ryzen AI Max+ 395 e 128 GB. O segundo teste mede a velocidade quando 32 768 tokens já estão na memória. É o da discussão nº 16578 do llama.cpp, e kyuz0 também o publica para o Ryzen.
Nosso protocolo foi congelado em 6 de outubro de 2026, às 13h30, antes da primeira medição. Um adendo do mesmo dia, às 23h45, acrescentou este formato de comparação.
As medições de leitura de 512 tokens e de escrita de 128 tokens são de 7 de outubro, às 22h38: cinco repetições por modelo, llama.cpp build 11430, atenção rápida (Flash Attention) ativada como nas medições do kyuz0, máquina sem nenhuma outra tarefa em execução. As medições com 32.768 tokens são de 6 de outubro. O método, os hashes dos arquivos e os dados das nossas tabelas estão publicados na nossa página de metodologia.
As velocidades estão em tokens por segundo (tok/s). Um token é um pedaço de palavra: em francês, equivale a cerca de dois terços de uma palavra. Os tamanhos de memória estão em GB (1 GB = 1.024 MB, como o Linux exibe); as taxas de transferência de memória em GB/s são as anunciadas pelos fabricantes, em unidades decimais. Estes são os comandos usados no ATOM:
Um cuidado: o build é o número de versão do llama.cpp, e as três máquinas não usam o mesmo. O Ryzen foi medido com os builds b9187 ou b9193 em maio de 2026, o Mac com o b10621 em agosto e o ATOM com o b11430 em outubro.
Um build mais recente pode ser mais rápido. Por uma questão de honestidade, também informamos, para o teste com 32.768 tokens, nossos números com o build 7941 de fevereiro de 2026, mais antigo que o do Ryzen (nenhuma medição publicada para o Mac nesse formato).
#Três máquinas com 128 GB: o que muda?
Aproveite a nossa experiência e um percurso guiado para escolher as ferramentas certas para o seu Mac e usar a sua IA no dia a dia.
- Espaço online vitalício
- PDF + arquivos
- Reembolsado em 30 dias
O GB10 da NVIDIA reúne 20 núcleos Arm e uma GPU Blackwell em torno de 128 GB de memória unificada (compartilhada pelo processador e pela GPU), com largura de banda anunciada de 273 GB/s. O Ryzen AI Max+ 395 da AMD (codinome Strix Halo) também compartilha 128 GB entre o processador e a GPU, com cerca de 256 GB/s em teoria. O M5 Max da Apple chega a 128 GB, com 614 GB/s e uma GPU de 40 núcleos.
| Máquina | Chip | Memória | Largura de banda |
|---|---|---|---|
| AI TOP ATOM (GIGABYTE) | NVIDIA GB10: 20 núcleos Arm e GPU Blackwell | 128 GB LPDDR5x | 273 GB/s |
| Ryzen AI Max+ 395 (números publicados em um Framework Desktop) | AMD Strix Halo | 128 GB LPDDR5x | cerca de 256 GB/s (teórico) |
| Mac M5 Max | Apple M5 Max: GPU de 40 núcleos | até 128 GB | 614 GB/s |
Para escrever cada token, o chip relê na memória os pesos ativos do modelo (os parâmetros usados naquele instante): a escrita acompanha, portanto, a largura de banda, e a leitura, que processa muitos tokens de uma vez, acompanha o poder de processamento da GPU.
O GB10 e o Ryzen têm largura de banda semelhante, e suas velocidades de escrita também são semelhantes. O M5 Max oferece 2,25 vezes a largura de banda do ATOM (614 contra 273 GB/s): no único modelo denso publicado, o llama 7B, ele escreve cerca de duas vezes mais rápido.
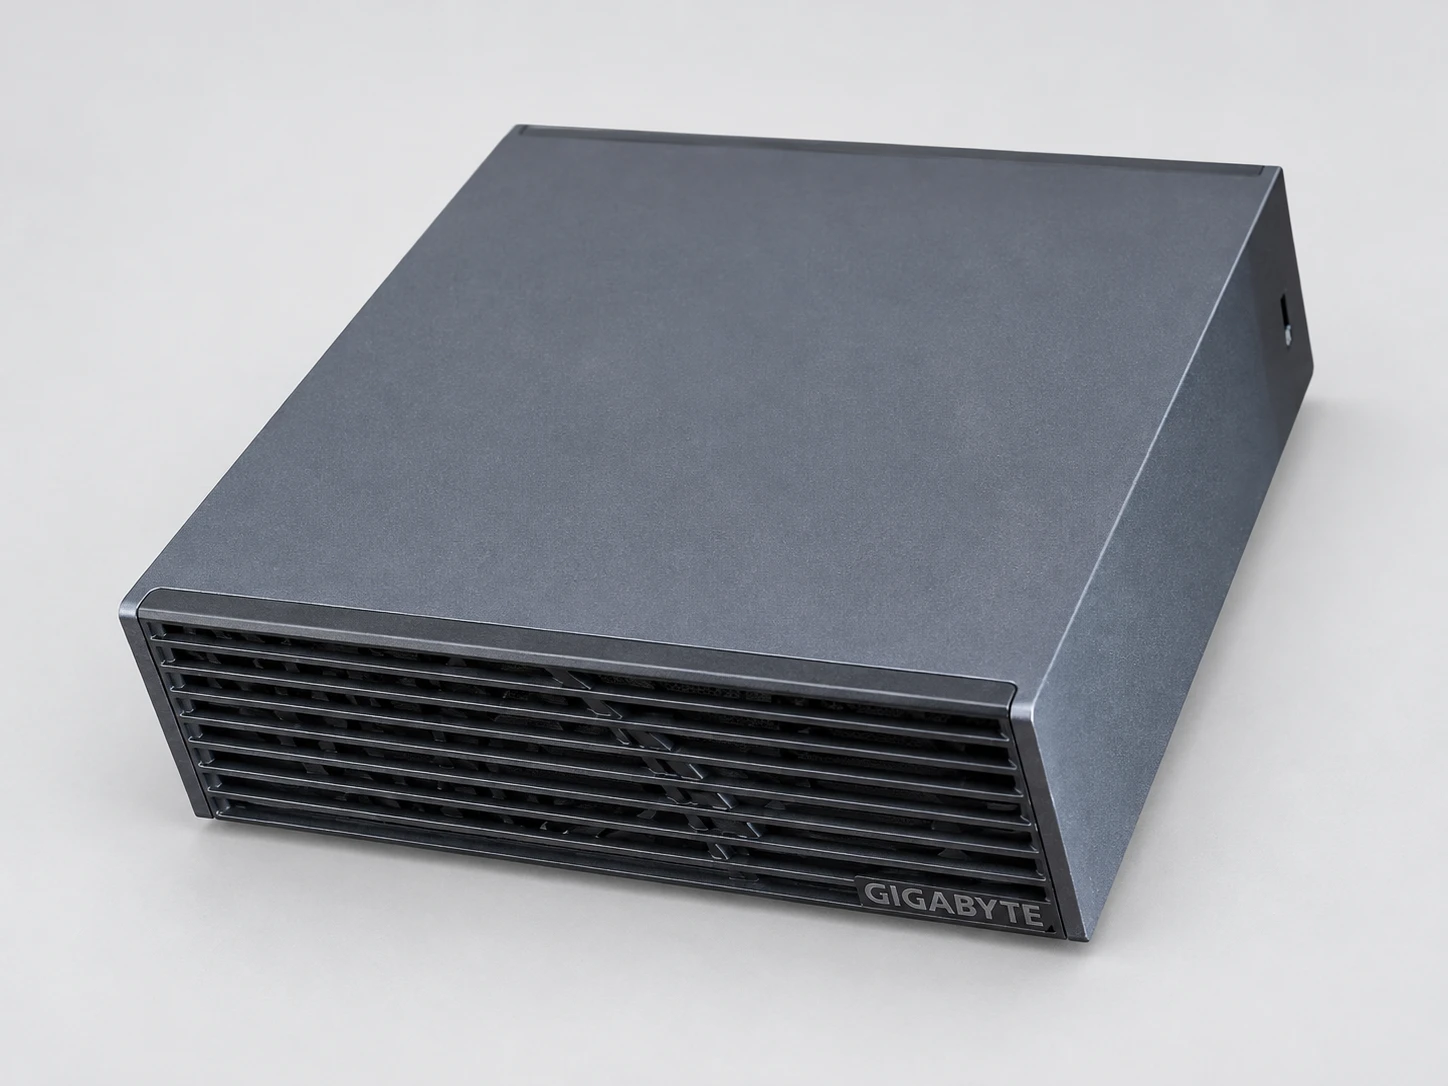
Até onde sabemos, todas as máquinas GB10 de 128 GB compartilham o mesmo chip NVIDIA. As velocidades deste guia são, portanto, as da plataforma. O que a GIGABYTE acrescenta é o gabinete de um litro (1,2 kg), o resfriamento, o acabamento e as referências comerciais.
Para verificar se a nossa unidade entrega de fato as velocidades da plataforma, reproduzimos a tabela publicada pelo projeto llama.cpp para o DGX Spark da NVIDIA, a máquina de referência da plataforma (build 7941, fevereiro de 2026). Em seis modelos e 60 pontos de medição, nossas leituras ficam em +0,3% na mediana (de −1,8% a +2,3%) e nossas escritas em −2,8% na mediana (de −4,3% a −0,3%): as duas máquinas estão no mesmo nível.
#Quem lê mais rápido?
A leitura é o ponto forte do ATOM. A tabela reúne os quatro modelos que conseguimos comparar com exatidão, ou seja, com o mesmo modelo e a mesma compressão em cada máquina. “llama 7B” designa o Llama 2 com 7 bilhões de parâmetros, o modelo de referência dessas publicações: é um modelo denso (usa todos os seus parâmetros a cada token), enquanto os outros três são modelos MoE (ativam apenas uma parte deles).

| Modelo | AI TOP ATOM | Ryzen, Vulkan | Ryzen, ROCm | Mac M5 Max | ATOM / melhor Ryzen |
|---|---|---|---|---|---|
| llama 7B (Q4_0) | 3 955,7 | 1 337,7 | 1 516,1 | 3 220,0 | × 2,6 |
| gpt-oss 20B (MXFP4) | 4 897,7 | 1 692,5 | 1 812,6 | — | × 2,7 |
| gpt-oss 120B (MXFP4) | 2 005,0 | 719,9 | 684,9 | — | × 2,8 |
| Nemotron-3 Super 120B (UD-Q4_K_XL) | 572,0 | 270,6 | 239,0 | — | × 2,1 |
Nesses quatro modelos, o ATOM lê de 2,1 a 2,8 vezes mais rápido que a melhor das duas stacks de software do Ryzen AI Max+ 395 (Vulkan e ROCm são duas formas de fazer a GPU da AMD processar). No gpt-oss 120B, ele lê 2 005 tokens por segundo: um prompt de 2 000 tokens, ou cerca de 1 300 palavras, é absorvido em um segundo.
Em relação ao Mac, temos apenas um ponto de comparação publicado no formato llama-bench: o modelo de referência da discussão nº 4167 do llama.cpp sobre os chips Apple, o llama 7B (Llama 2 com 7 bilhões de parâmetros) em Q4_0. Nele, o ATOM lê 3 955,7 tokens por segundo, contra 3 220,0 do M5 Max: 23% a mais.
Com Ollama (uma ferramenta que executa modelos localmente), em um documento de cerca de 17 000 tokens, nosso primeiro guia da série mede 1 816 tok/s em gpt-oss 120B para o ATOM, contra 1 388 de um MacBook Pro M5 Max medido por um leitor, em um texto semelhante, mas não idêntico (16 850 tokens para o ATOM, 16 689 para o Mac): 31% a mais.
Por que o ATOM lê tão rápido? A leitura é sobretudo cálculo, e a GPU Blackwell do GB10 tem núcleos dedicados a cálculos de IA (os «Tensor Cores» da NVIDIA). Esse é o critério que importa para um relatório de cinquenta páginas, um repositório de código ou um agente que relê seu histórico antes de cada resposta.
Dois cuidados na leitura. Primeiro, os builds são diferentes (10621 para o Mac, 11430 para o ATOM): considere a diferença de 23% como uma ordem de grandeza. Segundo, os dois modelos menores (llama 7B e gpt-oss 20B) variam de 3 a 5% de uma repetição para outra, porque esse teste dura cerca de um décimo de segundo. Ainda assim, duas séries distintas dão médias com diferença de até 1%: 3 955,7 e 3 920,2 para o llama 7B, 4 897,7 e 4 905,2 para o gpt-oss 20B.
#Quem escreve mais rápido?
A escrita é o ritmo com que a resposta aparece na tela. Ela acompanha a largura de banda da memória, que varia de uma máquina para outra.

| Modelo | AI TOP ATOM | Ryzen, Vulkan | Ryzen, ROCm | Mac M5 Max | ATOM / melhor Ryzen |
|---|---|---|---|---|---|
| llama 7B (Q4_0) | 59,4 | 55,7 | 51,3 | 119,9 | +7 % |
| gpt-oss 20B (MXFP4) | 85,1 | 79,8 | 73,0 | — | +7 % |
| gpt-oss 120B (MXFP4) | 58,8 | 56,6 | 51,5 | — | +4 % |
| Nemotron-3 Super 120B (UD-Q4_K_XL) | 17,1 | 14,9 | 14,4 | — | +15 % |
Em relação à melhor pilha de software do Ryzen AI Max+ 395, o ATOM escreve de 4 a 7% mais rápido em três modelos, e 15% mais rápido no Nemotron-3 Super 120B. É um nível próximo: as duas memórias têm larguras de banda semelhantes, e os builds são diferentes.
No gpt-oss 120B, um modelo de 117 bilhões de parâmetros, o ATOM gera 58,8 tokens por segundo em 128 tokens (58,0 em 32 tokens no nosso primeiro guia), o que é bem fluido para uma conversa; o Ryzen gera 56,6 no máximo.
O Mac M5 Max escreve mais rápido, cerca de duas vezes mais em um modelo denso pequeno (119,9 contra 59,4 tokens por segundo), graças à sua memória de 614 GB/s, ou seja, 2,25 vezes a do ATOM.
Em um modelo denso, o software pode acelerar a geração. Com um pequeno modelo "rascunho" que propõe tokens que o modelo grande valida de uma só vez (a decodificação especulativa), o Llama 3.3 70B no ATOM passa de 4,7 para 12 tokens por segundo em texto em francês (8 palavras de antecedência) e chega a 18,7 em código (16 palavras de antecedência): de 2,6 a 4 vezes mais rápido (llama-server b11430, rascunho Llama 3.2 1B, 6 e 7 de outubro de 2026). Essa técnica também existe nas outras máquinas; não a medimos nelas.
#O que acontece com um documento longo?
Quanto mais longo o texto já presente, mais lenta fica a continuação. O teste de contexto grande mede a leitura e a escrita quando 32 768 tokens já estão na memória, o que equivale a umas cinquenta páginas. A tabela compara o ATOM ao Ryzen AI Max+ 395 nos dois modelos gpt-oss, com dois builds para o ATOM. Até onde sabemos, não existe medição publicada no mesmo formato para o Mac.

| Modelo | Máquina e stack | Leitura com 32.768 | Geração com 32.768 |
|---|---|---|---|
| gpt-oss 120B | AI TOP ATOM, build 11430 | 1 832,4 | 42,2 |
| gpt-oss 120B | AI TOP ATOM, build 7941 | 1 551,3 | 41,3 |
| gpt-oss 120B | Ryzen AI Max+ 395, ROCm | 653,1 | 36,3 |
| gpt-oss 120B | Ryzen AI Max+ 395, Vulkan | 307,5 | 43,0 |
| gpt-oss 20B | AI TOP ATOM, build 11430 | 3 315,6 | 62,5 |
| gpt-oss 20B | AI TOP ATOM, build 7941 | 2 708,0 | 60,7 |
| gpt-oss 20B | Ryzen AI Max+ 395, ROCm | 1 124,1 | 52,2 |
| gpt-oss 20B | Ryzen AI Max+ 395, Vulkan | 555,7 | 61,1 |
Com gpt-oss 120B, o ATOM lê 1 832 tokens por segundo com 32 768 tokens de contexto: 2,8 vezes mais rápido que o Ryzen AI Max+ 395 em ROCm (653) e 6 vezes mais rápido que em Vulkan (308). Com o build 7941, mais antigo que o do Ryzen, a vantagem continua sendo de 2,4 vezes e de 5 vezes. Com gpt-oss 20B e o build 11430, a vantagem é de 2,9 e 6,0 vezes.
Na escrita com 32 768 tokens, o ATOM (42,2 tok/s no gpt-oss 120B) está no nível da melhor pilha do Ryzen (43,0 em Vulkan) e à frente da outra (36,3 em ROCm). O resultado, portanto, é simples: em um documento longo, a máquina da AMD escreve tão rápido quanto com sua melhor pilha (43,0 em Vulkan), mas leva de 2,8 a 6 vezes mais tempo para lê-lo.
Na prática, com o llama-server (o servidor do llama.cpp), nosso ATOM lê um documento de 30 000 tokens em 21,8 segundos com gpt-oss 120B e depois escreve a resposta a 42,8 tokens por segundo (medição do nosso primeiro guia da série).
#E com vários usuários?
Quando várias pessoas, ou vários agentes (programas de IA que trabalham sozinhos), consultam a máquina ao mesmo tempo, um servidor como o vLLM agrupa as solicitações e lê os pesos do modelo uma única vez para o conjunto delas. A largura de banda deixa então de ser o único gargalo: o poder de processamento do GB10 assume.
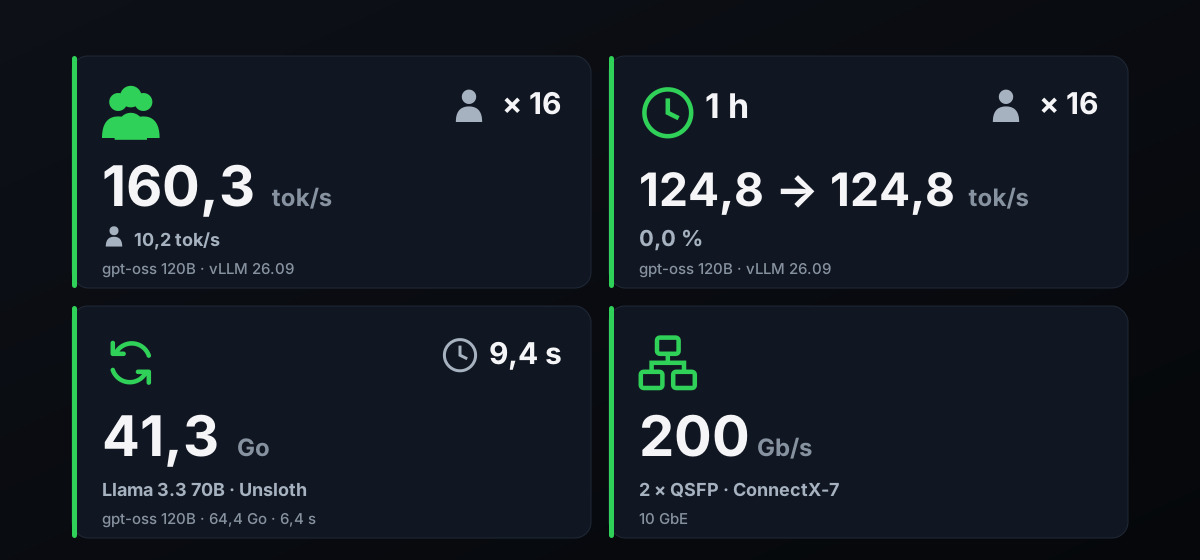
Em nosso primeiro guia, gpt-oss 120B passa de 35,6 tok/s para uma pessoa a 160,3 tok/s no total para 16 pessoas, cada uma ainda recebendo 10,2 tok/s. gpt-oss 20B passa de 49,1 a 322,4 tok/s no total, com 20,7 tok/s por pessoa (vLLM 26.09, 6 de outubro de 2026).
O desempenho sustentado importa tanto quanto o pico. Durante 1 h com 16 usuários (solicitações de 4.096 tokens, respostas de 512), o gpt-oss 120B manteve 124,8 tokens por segundo no total do início ao fim: de 122,6 a 128,1 nos 14 intervalos de medição, ou seja, 0,0 % de variação, com a GPU a no máximo 77 °C e nenhum throttling.
Durante 2 h com 8 usuários no Llama 3.3 70B em NVFP4 (um formato comprimido da NVIDIA), o throughput total passou de 38,7 para 38,5 tokens por segundo (−0,6%).
O StorageReview mediu uma carga do mesmo tipo com vLLM na máquina AMD Ryzen AI Halo, da família Ryzen AI Max, contra um DGX Spark. A máquina AMD ficou de 2 a 4 vezes atrás na maioria dos cenários de alta concorrência, e até 8,8 vezes atrás em um teste com leitura intensa com gpt-oss 120B. O DGX Spark usa o mesmo chip do ATOM; esses números do Ryzen vêm do teste do StorageReview.
#O que muda com CUDA, especialmente no treinamento?
CUDA é a plataforma de software da NVIDIA para computação em suas GPUs. No ATOM, com o DGX OS 7.5.0 (CUDA 13.0, driver 580.159.03), o llama.cpp compilado para o chip, o vLLM no contêiner fornecido pela NVIDIA e o Unsloth funcionaram em nossos testes. Até onde sabemos, muitas ferramentas de IA são escritas primeiro para CUDA: isso é uma vantagem tanto para servir modelos quanto para treiná-los.
Para o treinamento, a NVIDIA anuncia ajuste fino de modelos de até 70 bilhões de parâmetros na plataforma. Medimos dois casos com o Unsloth 2026.10.1 e o método QLoRA (um ajuste fino com pesos comprimidos em 4 bits), sequências de 1 024 tokens, 40 etapas, das quais as 10 primeiras servem de aquecimento.
O Llama 3.3 70B exige 41,3 GB de memória de GPU no pico e 9,4 segundos por etapa. O gpt-oss 120B exige 64,4 GB e 6,4 segundos por etapa. Portanto, dois modelos desse tamanho podem ser treinados dentro da memória do ATOM, com folga.
Um caso concreto: um ajuste fino leve do tipo LoRA, de 85 minutos, no Qwen3-8B (uma época, 2.000 exemplos) fez a proporção de notas fiscais extraídas sem nenhum erro passar de 26,0% para 95,0%, em 200 documentos nunca vistos e com uma avaliação rigorosa. É melhor que o gpt-oss 120B sem treinamento (62,5%). As notas fiscais são fictícias, geradas por nós. O guia da série dedicado ao fine-tuning detalha o método.
Duas portas QSFP (a placa de rede ConnectX-7, 200 Gb/s segundo a GIGABYTE) e uma porta 10 GbE completam a máquina. Segundo a GIGABYTE, até quatro máquinas GB10 podem ser interligadas em cluster; não testamos essa configuração.
#Quanto custam essas três máquinas?
Preços com impostos incluídos levantados em 8 de outubro de 2026 na França, nas páginas das lojas. Os preços do GB10 mudam toda semana: confira antes de comprar.
| Máquina | Configuração | Preço com impostos incluídos | Marchand |
|---|---|---|---|
| GMKtec EVO-X2 (Ryzen AI Max+ 395) | 128 GB, SSD de 2 TB | 3 449,99 € | gmktec.fr |
| Minisforum MS-S1 MAX (Ryzen AI Max+ 395) | 128 GB, SSD de 2 TB | 4 159,00 € | minisforumpc.fr |
| AI TOP ATOM ATAGB10-9001 | 128 GB, SSD de 4 TB PCIe 4.0 | 6 346,27 € (esgotada em 8 de outubro) | loja oficial AORUS (em estoque na Amazon.fr) |
| MSI EdgeXpert (GB10) | 128 GB, SSD de 4 TB | 6 599,95 € (sem estoque em 8 de outubro) | Materiel.net |
| AI TOP ATOM ATAGB10-9000 | 128 GB, SSD de 4 TB PCIe 5.0 | 7 999,95 € (sem estoque em 8 de outubro) | LDLC, Materiel.net |
| Mac Studio M5 Max (18 núcleos de CPU, 40 núcleos de GPU) | 128 GB, SSD de 512 GB | 5 859 € | apple.com/fr |
| Mac Studio M5 Max (18 núcleos de CPU, 40 núcleos de GPU) | 128 GB, SSD de 4 TB | 7 839 € (cálculo) | apple.com/fr, opções de armazenamento |
O Ryzen AI Max+ 395 é a máquina mais barata. Com o mesmo armazenamento de 4 TB, o ATOM 9000 (SSD PCIe 5.0, a versão que medimos) e um Mac Studio M5 Max ficam na mesma faixa de preço. O ATOM 9001, com SSD PCIe 4.0, é a máquina GB10 de 128 GB mais barata da tabela; até onde sabemos, ele mantém o mesmo chip e a mesma memória.
O SSD influencia sobretudo o tempo de carregamento de um modelo, não a sua velocidade de processamento; as medições de SSD se referem à versão 9000. Também informamos o preço de um Mac Studio M5 Max, porque ele usa o mesmo chip das máquinas medidas nas publicações; a velocidade dele não foi medida neste guia.
Os dois ATOM se diferenciam pelo gabinete de um litro (1,2 kg) e pelas escolhas da GIGABYTE: refrigeração, acabamento, modelos.
#O que esta comparação não diz
- Origem das medições
- Os números do Ryzen AI Max+ 395 (um Framework Desktop de 128 GB) e do Mac M5 Max vêm de publicações, com seu build e sua data; os mini PCs da tabela de preços não foram medidos. Considere diferenças de menos de 10 % como empate: os builds mudam, e duas unidades do mesmo modelo diferem em alguns pontos percentuais.
- O motor MLX da Apple não foi medido
- No Mac, o MLX pode gerar velocidades diferentes das do llama.cpp ou do Ollama. Nosso guia MLX vs. llama.cpp detalha essa diferença.
- Um único modelo em comum com o Mac
- O formato llama-bench publicado para o M5 Max abrange apenas o llama 7B. Para os modelos grandes, só temos a medição Ollama de um leitor.
- A qualidade das respostas
- Este guia compara velocidades, não a qualidade dos modelos.
- Vários usuários e treinamento nas outras máquinas
- Não os medimos nem no Ryzen nem no Mac. Para o Ryzen, citamos o StorageReview.
Atualizações e correções: esta página será revisada se um novo build do llama.cpp ou uma nova publicação alterar estes resultados; cada correção será datada.
#Para quem o ATOM é a escolha certa
O que vem a seguir se baseia em nossas medições no ATOM e nos números publicados citados acima.
- O ATOM é a escolha certa se você processa documentos longos ou código
- Ela lê gpt-oss 120B 2,8 vezes mais rápido que o Ryzen AI Max+ 395 com 32 768 tokens na memória, e um documento de 30 000 tokens em 21,8 segundos.
- … se várias pessoas ou agentes compartilham a máquina
- 160,3 tokens por segundo no total para 16 usuários com gpt-oss 120B; com solicitações mais longas, a taxa de transferência se manteve em 124,8 tokens por segundo durante 1 hora, sem queda.
- … se você treina ou adapta modelos
- Um QLoRA em 70 bilhões de parâmetros cabe em 41,3 GB. Um LoRA com notas fiscais levou 85 minutos.
- … se você quer grandes modelos MoE em um gabinete de um litro
- O gpt-oss 120B gera 58,8 tokens por segundo em uma máquina de 1,2 kg.
- Um Mac M5 Max é mais indicado se você gera texto sozinho com pequenos modelos densos
- Ele escreve cerca de duas vezes mais rápido no llama 7B (119,9 contra 59,4 tokens por segundo).
- Um mini-PC Ryzen AI Max+ 395 é mais indicado se o orçamento for decisivo
- A escrita fica próxima nos modelos MoE, a partir de 3.449,99 €, mas a leitura é de 2,1 a 2,8 vezes mais lenta.
Em resumo: se o seu trabalho consiste em ler textos longos, o ATOM é a escolha certa, segundo nossas comparações. Para atender várias pessoas ou treinar modelos, as medições dele mesmo são sólidas: 160,3 tokens por segundo no total para 16 usuários e um QLoRA de 70 bilhões de parâmetros em 41,3 GB. Se você escreve sozinho com modelos densos pequenos, considere o Mac. Se o orçamento for decisivo, considere o Ryzen.
#FAQ
Qual máquina é mais rápida entre o GB10, o Ryzen AI Max+ 395 e o Mac M5 Max?+
O AI TOP ATOM é mais rápido que um Mac M5 Max?+
Por que os números de uma mesma máquina mudam de um site para outro?+
Como comparar minha própria máquina com esses números?+
O Ryzen AI Max+ 395 é uma boa escolha em comparação com o GB10?+
Um comentário, um erro ou uma observação? Avise-nos; isso ajuda a melhorar o guia para todos.