GIGABYTE AI TOP ATOM: a GB10 de 128 GB medida em detalhes
O mini-PC de IA da GIGABYTE: chip NVIDIA GB10 e 128 GB de memória unificada em um litro. Vamos analisar o que importa para executar LLMs localmente: memória, largura de banda, velocidade, preço — e para quem é (ou não) a compra certa.
Atualizado em 10/10/2026
Onde comprar
A configuração indicada no botão é a oferecida na compra. Em mini-PCs, reserve memória para o sistema e verifique o motor de inferência; macOS/MLX e CUDA não são intercambiáveis.
Links afiliados — QualLLM pode receber uma comissão sobre as compras, sem custo adicional para você, o que não influencia estas recomendações (estabelecidas de forma independente). Como Parceiro Amazon, QualLLM obtém lucro com compras que atendem às condições exigidas.
Ficha técnica
- Memória128 GB unificados (LPDDR5x), 121,7 GB vistos pelo sistema
- Largura de banda273 GB/s
- CálculoGPU Blackwell e 20 núcleos Arm; até 1 PFLOP em FP4 com esparsidade, segundo NVIDIA (anúncio, não medido por nós)
- ConsumoAdaptador USB-C de 240 W; GPU a 10,4 W em repouso e de 39 a 53 W em média sob carga em nossas medições (apenas a GPU, sem wattímetro)
- Preço indicativo6 346,27 € (ATAGB10-9001, 4 TB PCIe 4.0, loja oficial da AORUS, esgotado; em estoque na Amazon.fr) · 7 999,95 € (ATAGB10-9000, 4 TB PCIe 5.0, LDLC e Materiel.net, esgotado) — verificado em 08/10/2026
- Maior modeloQwen3-235B-A22B em 3 bits (90,5 GB ocupados, 21 GB de margem) · Llama 3.3 70B a cerca de 5 tokens por segundo, 2,6 a 4 vezes mais rápido com um modelo de rascunho pequeno · gpt-oss 120B a 58 tokens por segundo; nossos 13 modelos, de 4B a 235B, cabem com 32 768 tokens de contexto
Para quem?
Vantagens e limitações
✓ Pontos fortes
- 128 GB de memória unificada: nossos 13 modelos, de 4B a 235B (em 3 bits), cabem com 32 768 tokens de contexto
- As velocidades do DGX Spark da NVIDIA, com no máximo 4,3% de diferença com llama.cpp e 2% de diferença com Ollama
- Velocidade estável sob carga contínua: 0,0% de variação em 1 h com 16 usuários, −0,6% em 2 h com 8 usuários, nenhum throttling reportado
- SSD PCIe 5.0 de 4 TB no ATAGB10-9000: 13 GB/s em leitura
- Pilha CUDA completa: llama.cpp, vLLM, TensorRT-LLM e Unsloth funcionaram conosco
- Chassi de um litro, 1,2 kg, painel frontal minimalista
✗ Limitações
- Preço superior ao de um mini-PC Ryzen AI Max+ 395 de 128 GB
- Um modelo denso de 70B escreve a cerca de 5 tokens por segundo, limite da largura de banda da plataforma GB10 (273 GB/s): um modelo MoE ou um pequeno modelo rascunho (×2,6 a ×4) proporciona velocidades de conversa
O que medimos
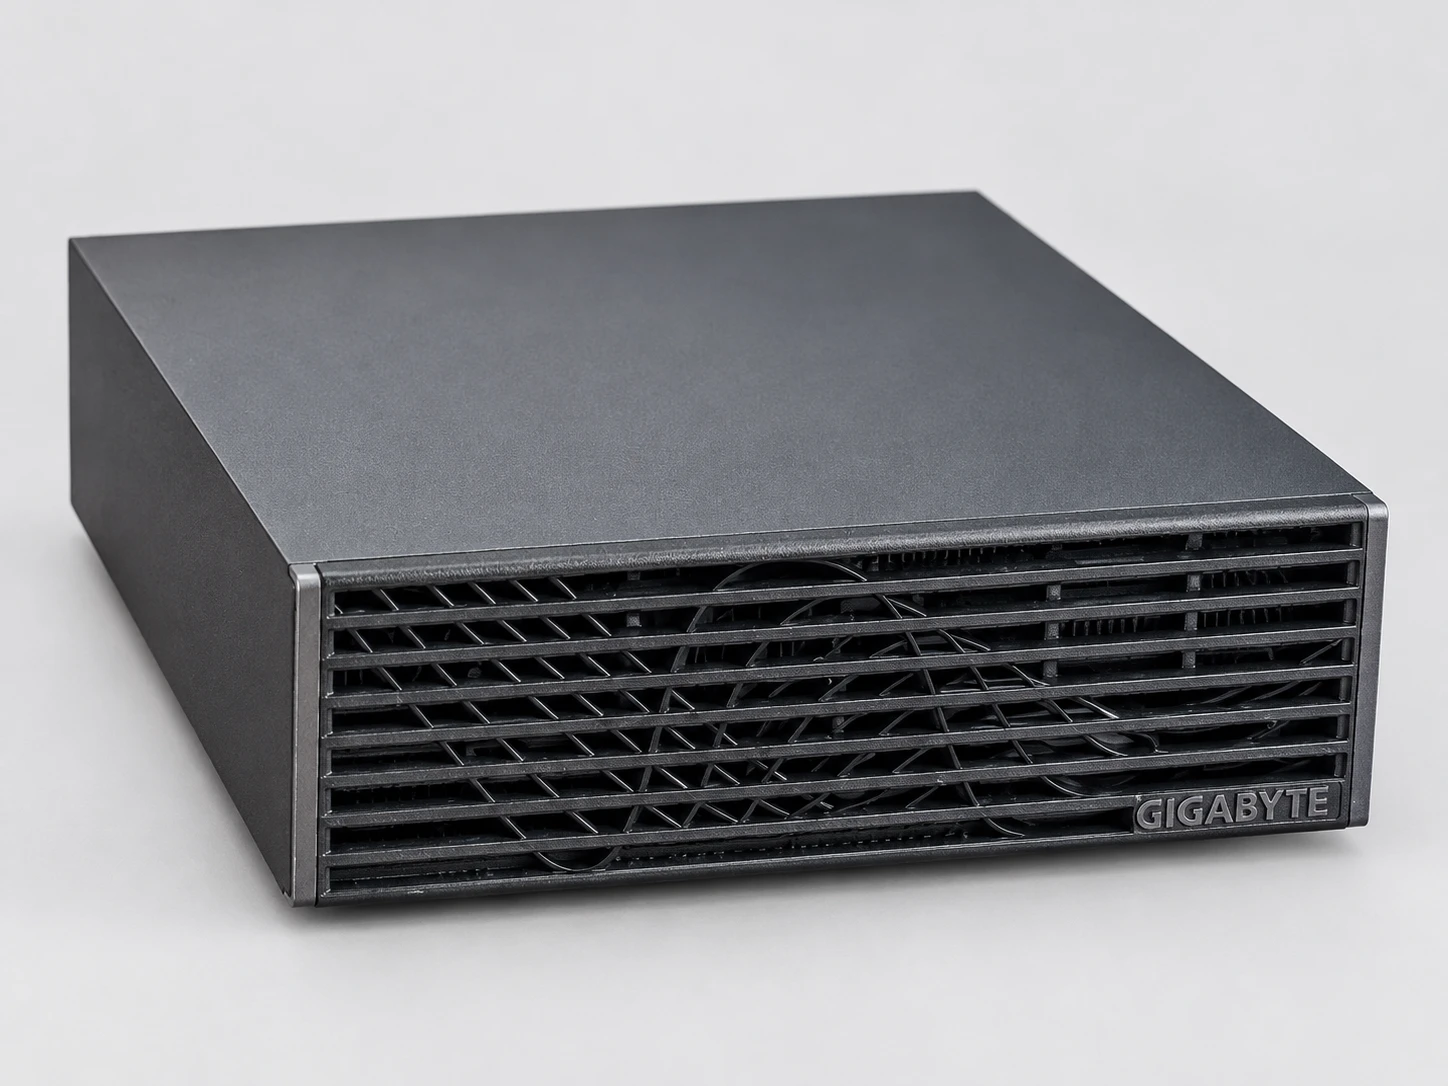
A GIGABYTE nos forneceu gratuitamente uma AI TOP ATOM (ATAGB10-9000: 128 GB, SSD de 4 TB PCIe 5.0) para uma série de guias. As medições e as opiniões são nossas; a GIGABYTE não revisou nem validou este conteúdo antes da publicação. O método (protocolo definido antes da primeira medição), as impressões digitais dos arquivos dos modelos e os dados de nossas tabelas estão publicados em nossa página do método. Nossos dados, infográficos e fotos podem ser reutilizados sob licença CC BY 4.0, citando QualLLM.
| Guide | O que ele mostra |
|---|---|
| Quais LLMs realmente rodam | 13 modelos de 4B a 235B: todos cabem com 32 768 tokens de contexto; gpt-oss 120B a 58 tokens por segundo |
A série conta com 7 guias, publicados um por semana: esta página é enriquecida a cada novo guia.
Os modelos GIGABYTE AI TOP ATOM
A GIGABYTE oferece o ATOM em seis referências, de ATAGB10-9000 a ATAGB10-9005. As três primeiras têm 128 GB: 9000 com um SSD de 4 TB em PCIe 5.0 (o que medimos), 9001 com 4 TB em PCIe 4.0, 9002 com 1 TB em PCIe 4.0. Uma versão de 64 GB foi anunciada a partir de 23 de outubro de 2026. Verifique a referência exata com o revendedor: algumas fichas descrevem incorretamente o SSD.
Para quem
- Uma equipe de 5 a 20 pessoas que quer um assistente de IA privado nos seus documentos (medido até 10 usuários simultâneos).
- Um desenvolvedor CUDA que quer a pilha NVIDIA completa na sua mesa.
- O fine-tuning local: LoRA de um Qwen3-8B, QLoRA de um 70B e de gpt-oss 120B com Unsloth.
- Os grandes modelos MoE de mais de 100 bilhões de parâmetros, a uma velocidade confortável.
Veredito
Perguntas frequentes
O GIGABYTE AI TOP ATOM consegue executar um LLM 70B localmente?
Qwen3-235B-A22B em 3 bits (ocupando 90,5 GB, 21 GB de margem) · Llama 3.3 70B a aproximadamente 5 tokens por segundo, 2,6 a 4 vezes mais rápido com um modelo rascunho pequeno · gpt-oss 120B a 58 tokens por segundo; nossos 13 modelos, do 4B ao 235B, cabem com 32 768 tokens de contexto.
Quanto custa o GIGABYTE AI TOP ATOM?
Considere 6 346,27 € (ATAGB10-9001, 4 TB PCIe 4.0, loja oficial da AORUS, esgotada; em estoque na Amazon.fr) · 7 999,95 € (ATAGB10-9000, 4 TB PCIe 5.0, LDLC e Materiel.net, esgotado) — levantamento de 08/10/2026 (versão de 64 GB anunciada por NVIDIA a partir de 4 999 $ (Estados Unidos), disponível a partir de 23/10/2026; a GIGABYTE confirmou uma AI TOP ATOM de 64 GB em 05/10/2026). Os preços variam rapidamente — verifique o preço do dia pelos links de compra.
Para quem é feito o GIGABYTE AI TOP ATOM?
Desenvolvedores CUDA, equipes que querem um assistente de IA privado, fine-tuning local, grandes modelos MoE com mais de 100B.