GB10 128 GB: quais LLMs realmente rodam (mesures)
Em uma GIGABYTE AI TOP ATOM (NVIDIA GB10, 128 GB), os 13 modelos medidos, do 4B ao 235B, funcionam com 32 768 tokens de contexto e pelo menos 20 GB de margem. Os grandes modelos MoE, que ativam apenas parte dos seus parâmetros a cada token, são muito mais rápidos que um modelo denso do mesmo tamanho: gpt-oss 120B escreve 58 tokens por segundo. Um modelo denso de 70B escreve a 4,8 tokens por segundo: é a largura de banda da memória, e não o espaço, que determina a velocidade.
Cento e vinte e oito gigabytes de memória unificada: essa é a vantagem das máquinas GB10 em relação às placas de vídeo. Mas o que realmente pode ser carregado nelas, com que margem e a que velocidade? Medimos 13 modelos, do 4B ao 235B, em uma AI TOP ATOM fornecida gratuitamente pela GIGABYTE, com um protocolo definido antes da primeira medição. Veja o que cabe, o que é agradável no dia a dia e para quem essa é a compra certa.
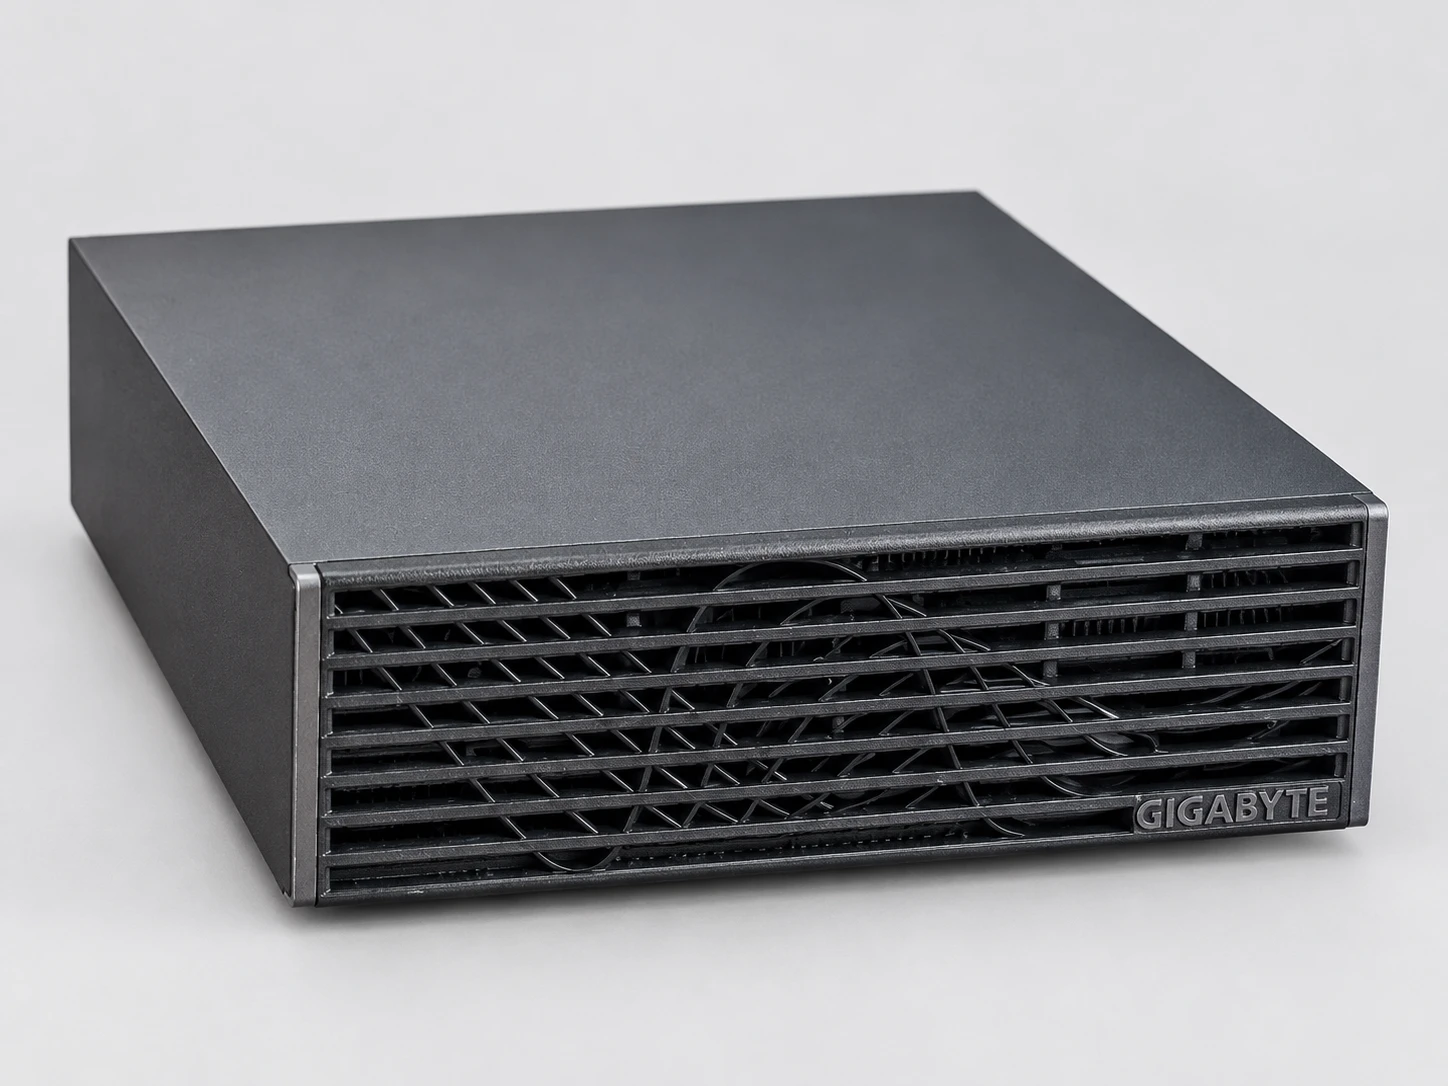
#A máquina testada
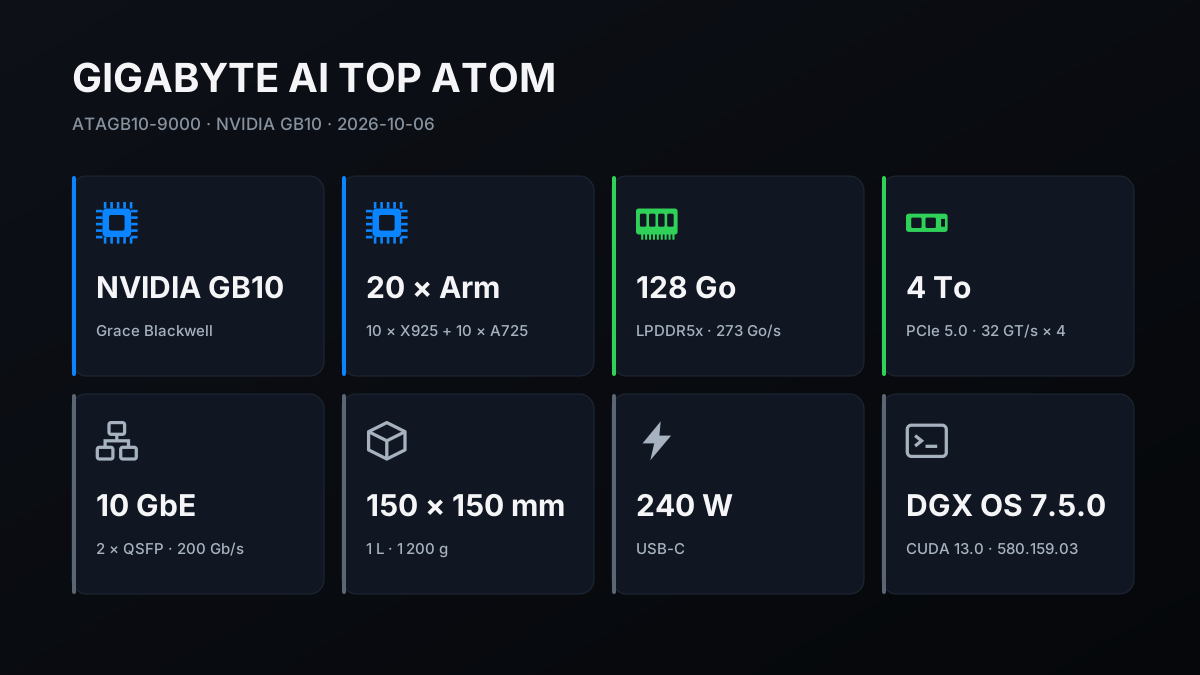
A máquina é uma GIGABYTE AI TOP ATOM, referência ATAGB10-9000: chip NVIDIA GB10 (20 núcleos Arm e uma GPU Blackwell compartilhando 128 GB de memória anunciada a 273 GB/s), SSD de 4 TB em PCIe 5.0. Ela roda DGX OS 7.5.0, o sistema de NVIDIA baseado no Ubuntu (driver 580.159.03, CUDA 13.0).
Três softwares foram usados. O llama.cpp, um mecanismo open source muito difundido para executar modelos localmente, compilado no local para o chip GB10, fornece a tabela principal. Ollama 0.34.1 serve para a comparação com um MacBook Pro M5 Max medido com a mesma versão. O vLLM 26.09, um servidor projetado para responder a várias pessoas ao mesmo tempo, roda no contêiner fornecido por NVIDIA.
#Como medimos
As velocidades do llama.cpp vêm de cinco repetições, com um desvio padrão (a dispersão entre repetições) de no máximo 3%. Os tempos de carregamento, a leitura de um documento de 30 000 tokens e as margens de memória são medições únicas; os testes com vários usuários são repetidos três vezes. Antes da primeira medição, um teste de três minutos verificou se a GPU mantinha sua potência de cálculo.
Os arquivos dos 13 modelos têm uma impressão digital SHA-256 (uma assinatura digital do arquivo) idêntica à publicada pelo Hugging Face, o site que hospeda esses modelos. O protocolo, redigido em 5 de outubro, foi congelado no dia 6 às 13h30, antes da primeira medição.
Um adendo do mesmo dia, por volta das 16 h 50, antecipou para a noite a nova medição a frio e acrescentou os testes reproduzidos aqui: script oficial de Ollama, decodificação especulativa, carga contínua e Llama 3.3 70B em NVFP4. O método, as hashes dos arquivos e os dados das nossas tabelas estão publicados em nossa página de método.
Os números principais foram medidos novamente a frio na mesma noite, após 20 minutos de descanso e com o cache limpo: no máximo 2,6% de diferença, abaixo do limite de 3% do protocolo.
#A mesma velocidade de um DGX Spark, com diferença de alguns por cento
Até onde sabemos, as máquinas GB10 de 128 GB compartilham o mesmo chip NVIDIA e a mesma memória; a construção, o resfriamento e o armazenamento podem variar. Para situar o ATOM, refizemos dois benchmarks publicados para o DGX Spark de NVIDIA, com a mesma versão do software e as mesmas configurações.
Com o llama.cpp (build 7941, o da tabela publicada pelo projeto; nossa tabela principal usa o build 11430, mais recente), em seis modelos comuns, a leitura é idêntica com diferença de até 2,3%; a escrita é inferior em 2,8% na mediana e em 4,3% no máximo. Com o script oficial do Ollama (versão 0.12.6, a usada nas medições publicadas), nossas três medições ficam a até 2% de diferença, tanto na leitura quanto na escrita: gpt-oss 20B, gpt-oss 120B e Llama 3.1 70B.
Portanto, as velocidades deste guia devem valer, com uma diferença de alguns por cento, para as outras máquinas GB10 de 128 GB; medimos apenas a ATOM. Sua construção e seu comportamento sob carga (temperaturas, estabilidade por 1 h e 2 h) são detalhados no próximo guia da série, e seu consumo em um guia dedicado.
#13 modelos, de 4B a 235B: espaço ocupado e velocidade
A tabela resume a campanha. “Memória ocupada” é a redução da memória disponível depois que o modelo é carregado com 32 768 tokens de contexto reservados. “Carregamento” é o tempo de carregamento a frio, com o cache do disco esvaziado. As velocidades vêm da ferramenta de medição llama-bench (llama.cpp, build 11430 de 5 de outubro de 2026), com o contexto vazio e depois com 32 768 tokens já presentes; as durações reais para um documento longo estão mais abaixo.
| Modelo | Tipo | Memória ocupada | Chargement | Escrita (vazio → 32k) | Leitura (vazio → 32k) | Uso |
|---|---|---|---|---|---|---|
| Gemma 3 4B (Q4_0) | dense | 4,6 GB | 3 s | 80,8 → 63,6 | 6 239 → 5 409 | muito fluido |
| Qwen2.5-Coder 7B (Q8_0) | dense | 10,2 GB | 3 s | 30,0 → 23,3 | 3 746 → 2 138 | fluide |
| gpt-oss 20B (MXFP4) | MoE, 3,6 bi ativos | 13,0 GB | 4 s | 81,4 → 62,5 | 4 950 → 3 316 | muito fluido |
| Qwen3.8 27B (Q4_K_XL) | dense | 19,1 GB | 5 s | 11,8 → 10,6 | 865 → 717 | correct |
| Qwen3.6 35B-A3B (Q4_K_XL) | MoE, 3 bi ativos | 22,4 GB | 5 s | 66,0 → 55,6 | 2 987 → 2 429 | muito fluido |
| GLM-4.7-Flash (Q8_0) | MoE, 3 bi ativos | 32,6 GB | 6 s | 51,4 → 35,5 | 2 392 → 608 | muito fluido |
| Qwen3-Coder 30B-A3B (Q8_0) | MoE, 3,3 bi ativos | 34,3 GB | 6 s | 62,6 → 33,2 | 3 377 → 1 603 | muito fluido |
| Llama 3.3 70B (Q4_K_M) | dense | 51,1 GB | 8 s | 4,8 → 3,9 | 405 → 269 | ideal para processamento em lotes |
| gpt-oss 120B (MXFP4) | MoE, 5,1 bi ativos | 61,7 GB | 10 s | 58,0 → 42,2 | 2 609 → 1 832 | muito fluido |
| Qwen3.5 122B-A10B (Q4_K_XL) | MoE, 10 bi ativos | 74,5 GB | 12 s | 23,1 → 21,4 | 1 126 → 945 | fluide |
| Nemotron-3 Super 120B-A12B (Q4_K_XL) | MoE, 12 bi ativos | 80,4 GB | 12 s | 16,9 → 16,5 | 851 → 809 | correct |
| Qwen3.8-Flash-Next 125B (IQ4_XS) | MoE, aproximadamente 6 bi ativos | 89,5 GB | 21 s | 27,3 → 25,2 | 1 073 → 917 | fluide |
| Qwen3-235B-A22B (Q2_K_XL) | MoE, 22 bi ativos | 90,5 GB | 12 s | 17,7 → 11,8 | 588 → 331 | correto; compressão forte (Q2) |
Para ler a tabela: um modelo denso faz todos os seus parâmetros trabalharem a cada token; um modelo MoE (« mixture of experts »), apenas uma fração, indicada em bilhões (Md). A sigla entre parênteses designa a compressão dos pesos. Em nossos arquivos, Q8 ocupa 8,5 bits por parâmetro, os formatos Q4 e MXFP4, de 4,3 a 5,6 bits, e Q2_K_XL, 3 bits: é a compressão mais forte da tabela.
A coluna « Uso » aplica nossas referências à velocidade de escrita com contexto vazio: muito fluido acima de 40 tokens por segundo, fluido de 20 a 40, aceitável de 10 a 20. Abaixo disso, reservamos o modelo para processamento em lote.
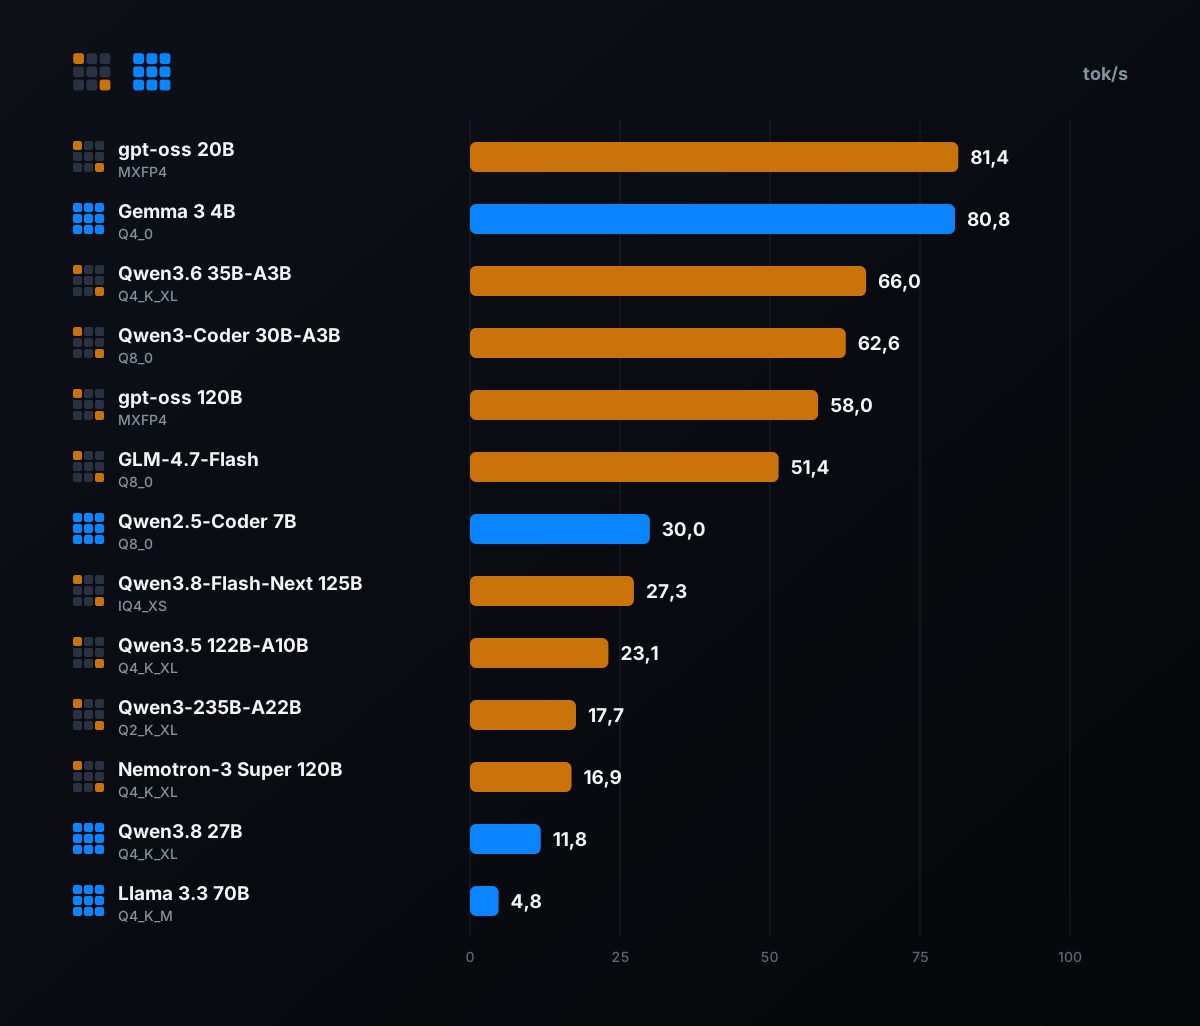
Primeiro aprendizado: nada nesta tabela coloca a máquina em dificuldade; até o Qwen3-235B deixa 21 GB livres com 30 000 tokens de contexto. Segundo aprendizado, mais útil para escolher: o espaço quase nunca é um limite; é a escolha do modelo que determina a velocidade, de 4,8 a 81,4 tokens por segundo.
#O que determina a velocidade: os parâmetros ativos, não o tamanho
Para escrever cada token, o chip precisa reler na memória os pesos usados por esse token. Com 273 GB/s de largura de banda, a velocidade máxima é calculada de forma simples: 273 dividido pelo volume de pesos lidos a cada token. Um modelo denso lê todos os seus pesos todas as vezes; um modelo MoE lê apenas uma fração deles, os « especialistas » escolhidos para esse token.
É isso que explica o paradoxo da tabela. O arquivo de gpt-oss 120B pesa 59 GB, mas o modelo ativa apenas 5,1 bilhões de parâmetros por token: ele escreve a 58,0 tokens por segundo. O Qwen3.8 27B, cujo arquivo é mais de três vezes mais leve (16 GB), é um modelo denso: ativa seus 27 bilhões de parâmetros a cada token e escreve a 11,8 tokens por segundo. O modelo maior é quase cinco vezes mais rápido que o menor.
| Modelo | Parâmetros ativos | Limite teórica | Medido | Proporção do limite máximo |
|---|---|---|---|---|
| Qwen2.5-Coder 7B (denso) | 7,6 bi | 33,7 | 30,0 | 89 % |
| Llama 3.3 70B (denso) | 70,6 bi | 6,4 | 4,8 | 74 % |
| Qwen3.8 27B (denso) | 27,3 bi | 15,6 | 11,8 | 76 % |
| Qwen3-Coder 30B-A3B (MoE) | 3,3 bi | 77,8 | 62,6 | 81 % |
| gpt-oss 120B (MoE) | 5,1 bi | 98,7 | 58,0 | 59 % |
| Qwen3.6 35B-A3B (MoE) | 3 bi | 141,1 | 66,0 | 47 % |
A tabela reúne seis modelos, aqueles cujo número de parâmetros ativos é publicado ou medido pelo llama.cpp. Os modelos densos chegam a 74 a 89% desse limite: a GB10 utiliza quase toda a sua memória.
Entre os treze modelos, os oito MoE fora o Qwen3.8-Flash-Next atingem de 47 a 81%, e seis deles ficam entre 52 e 62%; a escolha dos especialistas e os cálculos auxiliares provavelmente acrescentam um tempo fixo a cada token. O Qwen3.8-Flash-Next não entra nesse cálculo: ele conta com 51 bilhões de parâmetros de tabela de consulta além de seus 125 bilhões, o que torna a estimativa inadequada.
Em tamanho comparável, os MoE ainda são muito mais rápidos. Daí nossa principal recomendação: em uma máquina GB10, para um modelo grande, prefira um MoE. Um modelo denso pequeno como Gemma 3 4B também escreve muito rapidamente (80,8 tokens por segundo), mas é bem menor e serve para outros usos.
#Os modelos com mais de 100 bilhões de parâmetros
Essa é a razão de existir dos 128 GB. NVIDIA anuncia para a plataforma modelos de até 200 bilhões de parâmetros; nossas medições confirmam essa promessa, e um 235B comprimido a 3 bits cabe até mesmo com folga. Cinco modelos com mais de 100 bilhões de parâmetros cabem no ATOM, todos com pelo menos 20 GB de margem com 30.000 tokens de contexto.
- gpt-oss 120B, o melhor equilíbrio entre velocidade e espaço
- 58,0 tokens por segundo, 61,7 GB ocupados com seu contexto, carregado em 10 segundos. A OpenAI o publica diretamente no formato MXFP4: ele cabe sem compressão adicional.
- Qwen3.8-Flash-Next 125B, o mais rápido dos Qwen gigantes
- 27,3 tokens por segundo com aproximadamente 6 bilhões de parâmetros ativos, ocupando 89,5 GB em IQ4_XS. Sua versão Q4_K_XL, menos comprimida, também cabe, com uma margem estreita (veja mais abaixo).
- Qwen3.5 122B-A10B
- 23,1 tokens por segundo, 74,5 GB; seus dez bilhões de parâmetros ativos o colocam atrás do gpt-oss.
- Nemotron-3 Super 120B-A12B (NVIDIA)
- 16,9 tokens por segundo, 80,4 GB. Com doze bilhões de parâmetros ativos, ele escreve mais devagar que o gpt-oss, e é o modelo cuja escrita se mantém melhor à medida que o contexto aumenta: de 16,5 a 32 768 tokens, cerca de 3% a menos.
- Qwen3-235B-A22B, à parte
- Ele cabe em Q2_K_XL, a compressão mais forte da tabela (3 bits por parâmetro, em média): 17,7 tokens por segundo, 90,5 GB. Uma compressão tão forte geralmente reduz a qualidade das respostas; nós não a medimos.
#Onde a memória termina: cerca de 100 a 105 GB de pesos
O sistema detecta 121,7 GB de memória: parte dos 128 fica reservada desde a inicialização. Depois que a máquina foi iniciada, sem nada mais na memória, restavam de 108 a 113 GB disponíveis, conforme o momento. Para encontrar o limite, carregamos duas versões mais pesadas dos maiores modelos, com o mesmo contexto de 32.768 tokens e uma proteção que interrompe o carregamento se a memória livre cair abaixo de 3 GB.
| Modelo | Arquivo | Memória ocupada | Espaço restante | Escrita (após 4 000 → 30 000 tokens lidos) | Place |
|---|---|---|---|---|---|
| Qwen3.8-Flash-Next 125B (Q4_K_XL) | 103,7 GB | 107,0 GB | 6,0 GB | 24,9 → 21,9 tok/s | apenas |
| Qwen3-235B-A22B (Q3_K_XL, 3,5 bits) | 97,0 GB | 104,7 GB | 8,2 GB | 13,9 → 10,4 tok/s | apenas |
Nenhum modelo falhou ao carregar, mas estes dois deixam uma margem estreita: quase não sobra espaço para um segundo modelo, um contexto muito mais longo ou um aplicativo exigente ao lado. Portanto, o limite prático fica em torno de 100 a 105 GB de pesos. Isso exclui, por exemplo, os pesos NVFP4 (um formato compactado de NVIDIA) do Qwen3.8-Flash-Next: cerca de 135 GB segundo o blog Kubesimplify (27 de agosto de 2026), que esclarece que, nesse caso, são necessárias duas máquinas.
A mesma publicação já mostrava o modelo em uma única máquina no formato GGUF (o formato do llama.cpp), mas naquela época só existia a versão mais comprimida. No ATOM, as versões IQ4_XS e Q4_K_XL funcionam, com 21 e 6 GB de margem.
#O preço do contexto longo
Um documento longo, uma base de código ou uma conversa que se estende: cada token já presente no contexto torna o restante mais lento. Com 32.768 tokens na memória, a velocidade de escrita cai de 3 a 47%, dependendo do modelo. Também medimos o tempo real para ler de uma só vez um documento de 30.000 tokens, cerca de cinquenta páginas.
| Modelo | Leitura de 30 000 tokens | Escrita em seguida |
|---|---|---|
| Gemma 3 4B | 4,7 s | 60,8 tok/s |
| gpt-oss 20B | 8,1 s | 61,6 tok/s |
| Qwen2.5-Coder 7B | 12,7 s | 23,3 tok/s |
| Qwen3.6 35B-A3B | 14,2 s | 54,4 tok/s |
| Qwen3-Coder 30B-A3B | 17,4 s | 33,3 tok/s |
| gpt-oss 120B | 21,8 s | 42,8 tok/s |
| GLM-4.7-Flash | 32,7 s | 35,6 tok/s |
| Qwen3.8 27B | 39,4 s | 10,6 tok/s |
| Qwen3.8-Flash-Next 125B | 42,9 s | 23,0 tok/s |
| Qwen3.5 122B-A10B | 43,6 s | 21,2 tok/s |
| Nemotron-3 Super 120B-A12B | 55,4 s | 16,2 tok/s |
| Qwen3-235B-A22B | 1 min 33 s | 12,1 tok/s |
| Llama 3.3 70B | 1 min 44 s | 4,0 tok/s |
Para a maioria dos modelos, esses tempos são mais longos do que sugere a coluna « Leitura » da primeira tabela. O motivo provável: llama-server, o servidor usado na prática, processa por padrão o texto em lotes de 512 tokens, contra 2 048 em nossa configuração do llama-bench.
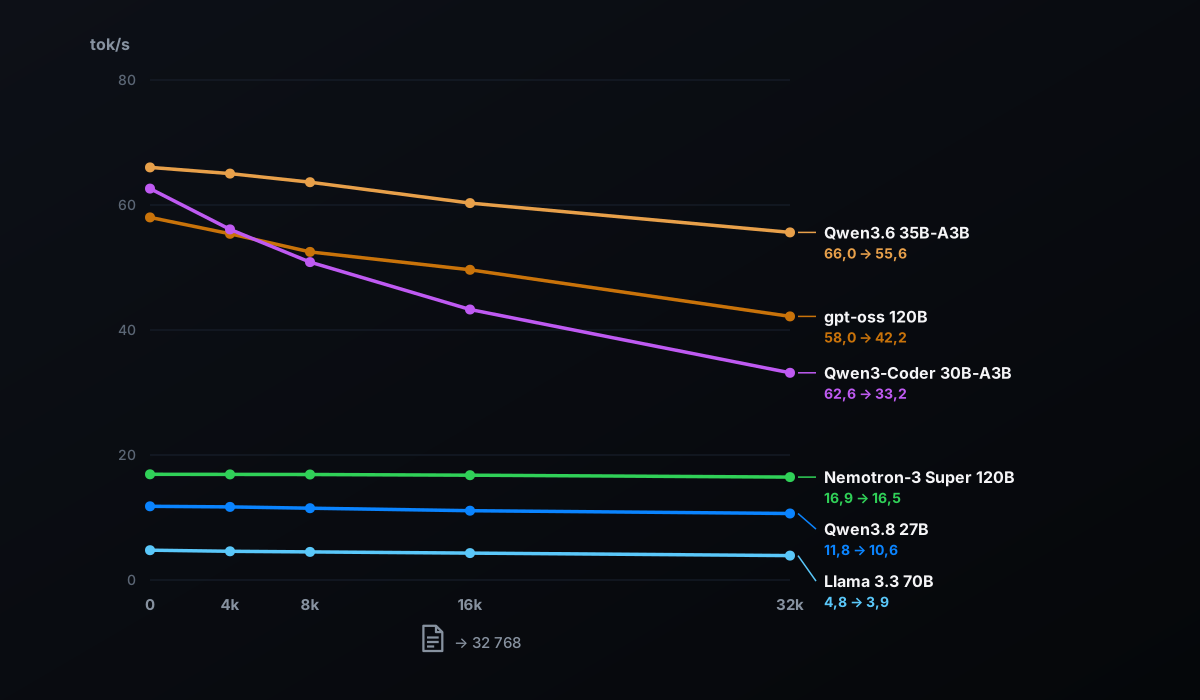
A leitura é um ponto forte da GB10: em comparação com o Mac analisado mais abaixo, ela lê gpt-oss 120B 31% mais rápido. Se você enviar um relatório de cerca de cinquenta páginas, a resposta começa 22 segundos depois com gpt-oss 120B, e 1 min 44 s depois com um 70B denso. Para análise de documentos e agentes de código, esse critério pesa muito.
#Até 16 usuários ao mesmo tempo: o que a máquina aguenta
Com o vLLM, simulamos 1, 8 e depois 16 usuários simultâneos. Cada um envia uma solicitação de 1 024 tokens e recebe uma resposta de 512 tokens; cada ponto é medido três vezes com solicitações diferentes, e publicamos a mediana.
| Modelo | Usuários | Total | Por pessoa | Primeira palavra (média) | Primeira palavra (casos mais lentos) |
|---|---|---|---|---|---|
| gpt-oss 120B | 1 | 35,6 tok/s | 36,4 tok/s | 0,34 s | 0,35 s |
| gpt-oss 120B | 8 | 113,9 tok/s | 14,5 tok/s | 0,97 s | 1,62 s |
| gpt-oss 120B | 16 | 160,3 tok/s | 10,2 tok/s | 1,07 s | 3,71 s |
| gpt-oss 20B | 1 | 49,1 tok/s | 50,0 tok/s | 0,16 s | 0,16 s |
| gpt-oss 20B | 8 | 205,9 tok/s | 26,5 tok/s | 0,49 s | 0,81 s |
| gpt-oss 20B | 16 | 322,4 tok/s | 20,7 tok/s | 0,52 s | 1,73 s |
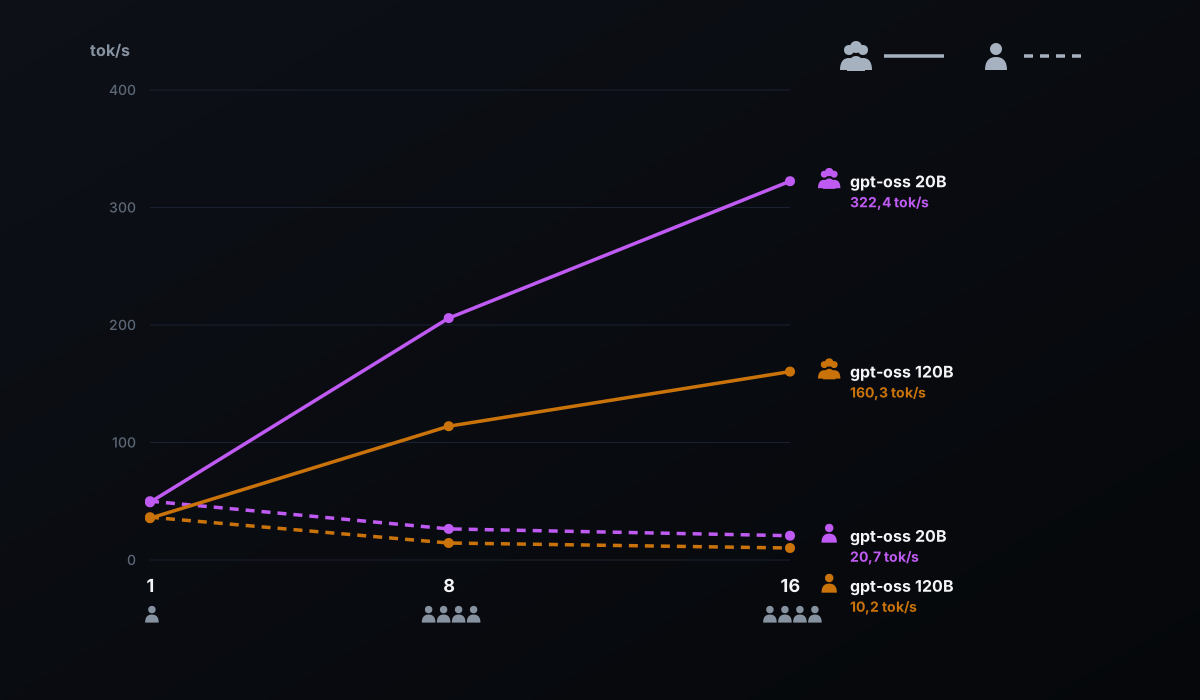
Entre 1 e 16 usuários, a vazão total é multiplicada por 4,5 com gpt-oss 120B e por 6,6 com gpt-oss 20B: quando várias solicitações compartilham a leitura dos mesmos pesos, o chip aproveita plenamente seu poder de computação.
Com 16 pessoas, cada uma ainda vê sua resposta sendo escrita a 10 tokens por segundo com gpt-oss 120B, e a 21 com gpt-oss 20B. Com o modelo de 120 bilhões, a primeira palavra chega em pouco mais de um segundo, em média, e em quase 4 segundos nos casos mais lentos.
Para uma pessoa sozinha, porém, o vLLM não é o mais rápido: sem nenhuma configuração específica de desempenho, ele escreve a 36,4 tokens por segundo em gpt-oss 120B, contra 54,4 do llama.cpp em respostas longas. Seus logs mostram que ele escolhe, na GB10, o kernel de computação Marlin para o formato MXFP4, o que provavelmente explica a diferença. O vLLM faz sentido assim que várias pessoas ou vários agentes compartilham a máquina.
#Sozinho diante da máquina: Ollama ou llama.cpp?
Ollama é a maneira mais simples de começar e funciona na GB10 sem ajustes. No gpt-oss, porém, não é o mais rápido. Em respostas longas, a versão 0.34.1 escreve a 42,3 tokens por segundo em gpt-oss 120B, contra 54,4 do llama.cpp no mesmo formato MXFP4, ou seja, 22% menos. Em gpt-oss 20B: 58,8 contra 78,8, ou seja, 25% menos.
Nos modelos Qwen, ocorre o inverso. No Qwen3.8 27B, Ollama escreve entre 22,9 e 30,5 tokens por segundo, dependendo do trecho, contra 11,8 do llama.cpp configurado com os valores padrão; no Qwen3.6 35B-A3B, entre 90,5 e 94,9, contra 66,0. O motivo provável: Ollama ativa por padrão uma decodificação especulativa, que propõe vários tokens antecipadamente e que o modelo valida de uma vez (a configuração draft_num_predict aparece na configuração desses modelos).
Nosso teste aponta nessa direção. No llama-server (seis textos de 400 tokens, prosa e código), a decodificação especulativa do llama.cpp (MTP, que prevê vários tokens de uma vez) faz o Qwen3.8 27B passar de 11,7 para 21,5 tokens por segundo em prosa, e de 11,6 para 27,2 em código.
Na prática: Ollama para começar e para os modelos Qwen, que ele acelera por padrão; llama.cpp para extrair o máximo do gpt-oss ou do Qwen3.8 ativando sua decodificação especulativa. A melhor escolha depende mais das configurações do que da máquina.
#Diante do MacBook Pro M5 Max de 128 GB
Um leitor mediu seu MacBook Pro M5 Max de 128 GB (GPU de 40 núcleos) em 16 de setembro com Ollama 0.34.1, em uma única passagem por modelo; suas medições estão publicadas em nosso guia dedicado. Repetimos as mesmas séries no ATOM, em duas passagens: mesma versão de Ollama, mesmos modelos, mesmo prompt.
| Medição | ATOM, 1ª passagem | ATOM, 2ª passagem | MacBook Pro M5 Max | Diferença |
|---|---|---|---|---|
| Escrita, gemma4:12b | 45,9 | 54,1 | 58,1 | Mac +7 a +27 % |
| Escrita, qwen3.8:27b | 30,5 | 22,9 | 36,6 | Mac +20 a +59 % |
| Escrita, gpt-oss:20b | 58,1 | 58,8 | 113,4 | Mac +93 a +95 % |
| Escrita, gpt-oss:120b | 42,2 | 42,3 | 79,1 | Mac +87 % |
| Leitura, gpt-oss:120b | 1 816 | — | 1 388 | ATOM +31% |
O Mac escreve mais rápido nos quatro modelos, quase duas vezes mais rápido nos dois gpt-oss, cujas passagens são concordantes: seu chip dispõe de 614 GB/s de largura de banda, mais que o dobro da GB10. Em gemma4 e qwen3.8, a diferença varia de uma passagem para outra; a decodificação especulativa, cujo ganho depende do texto gerado, é uma possível explicação.
O ATOM lê mais rápido, provavelmente graças ao poder de processamento de sua GPU, em textos semelhantes, mas não idênticos (16.850 e 16.689 tokens). Com llama.cpp, a diferença de escrita diminui: 54,4 tokens por segundo no gpt-oss 120B, contra 79,1 no Mac com Ollama.
#Para quem o ATOM é a escolha certa
O que segue vem de nossas medições no ATOM.
- O ATOM é a escolha certa se você quer modelos grandes em casa
- Cinco modelos com mais de 100 bilhões de parâmetros cabem com folga. Até onde sabemos, nenhuma placa de vídeo para o consumidor se aproxima desses 128 GB.
- … se você trabalhar com documentos longos ou código
- 30.000 tokens lidos em 22 segundos com gpt-oss 120B.
- … se várias pessoas ou agentes a compartilharem
- 160 tokens por segundo no total para 16 usuários no gpt-oss 120B.
- … se você quer o ecossistema NVIDIA
- CUDA 13, vLLM no contêiner de NVIDIA e llama.cpp compilado para o chip GB10 funcionaram conosco no DGX OS 7.5.0.
- Se você está sozinho e prioriza a velocidade de escrita
- Compare com o MacBook Pro M5 Max: graças aos seus 614 GB/s, ele escreve mais rápido no gpt-oss, enquanto o ATOM lê um documento longo 31% mais rápido no gpt-oss 120B. Compare também os preços.
- Se seus modelos permanecerem abaixo de 35 GB
- A versão de 64 GB do ATOM, anunciada para 23 de outubro de 2026, deve ser suficiente (cálculo baseado em nossas medições, não medido nessa versão).
#64 ou 128 GB?
Em 2 de outubro de 2026, NVIDIA anunciou DGX Spark de 64 GB para modelos de até 100 bilhões de parâmetros, disponíveis em 23 de outubro na Acer, ASUS, Dell, GIGABYTE, HP e MSI, a partir de 4 999 dólares. A GIGABYTE confirmou em 5 de outubro uma AI TOP ATOM de 64 GB com o mesmo design. Nós não a medimos.
Nossas medições permitem fazer um cálculo. Os modelos até Qwen3-Coder 30B-A3B ocupam menos de 35 GB com 32 768 tokens de contexto e caberiam; o Llama 3.3 70B (51 GB) ficaria no limite. gpt-oss 120B (62 GB) e os modelos maiores não caberiam. Com a mesma largura de banda, algo que será preciso verificar, as velocidades devem ser próximas.
Para um modelo com mais de 100 bilhões de parâmetros em uma única máquina, a versão de 128 GB é indispensável. Segundo NVIDIA, duas máquinas de 64 GB conectadas também combinam sua memória; não testamos isso.
#Os preços registrados
Em 8 de outubro de 2026, a versão de 4 TB em PCIe 4.0 (ATAGB10-9001, mesmo chip GB10 e os mesmos 128 GB) era exibida por 6 346,27 € com impostos incluídos na loja oficial da AORUS, esgotada; estava em estoque na Amazon.fr, vendida pela Amazon UK (uma unidade). A versão testada, de 4 TB em PCIe 5.0 (ATAGB10-9000), custava 7 999,95 € na LDLC e na Materiel.net, esgotada.
Os preços e os estoques dessas máquinas mudam rapidamente: verifique-os antes de comprar.
#Nosso julgamento
O ATOM é uma excelente escolha para executar em casa um modelo de 120 bilhões de parâmetros, compartilhá-lo com uma equipe ou ler rapidamente documentos longos. Ele nos proporcionou o desempenho de referência da plataforma, sem limitação térmica registrada em nossas medições, inclusive durante uma hora de carga contínua com 16 usuários. Se o orçamento for importante, sua versão PCIe 4.0 mantém o mesmo chip e a mesma memória.
#O que não medimos
- A qualidade das respostas
- Este guia mede o que cabe e em que velocidade, não o valor de cada modelo.
- As temperaturas, o ruído e o consumo
- O próximo guia da série detalha as temperaturas sob carga prolongada; o consumo tem seu próprio guia, medido no chip (somente a GPU). Quanto ao ruído, citamos as medições da Hardware & Co.
- Contextos além de 32 768 tokens
- Vários modelos aceitam contextos bem mais longos; este guia para em 32 768 tokens, e o tutorial de 70B da série chega a 131 072 tokens para Llama 3.3 70B e gpt-oss 120B.
- As outras máquinas GB10 e a versão de 64 GB
- Nossos números coincidem com os publicados para o DGX Spark da NVIDIA, mas medimos apenas o ATOM 128 GB.
Atualizações e correções: esta página será revisada se uma nova versão do DGX OS, do llama.cpp ou de Ollama alterar estes resultados; cada correção será datada.
#FAQ
Qual é o maior modelo que podemos executar em uma máquina GB10 de 128 GB?+
Um modelo 70B pode ser usado no dia a dia em uma GB10?+
As velocidades deste guia valem para um DGX Spark de NVIDIA ou de outra marca?+
É melhor escolher a versão de 64 GB ou de 128 GB?+
Ollama é a melhor escolha em uma máquina GB10?+
Um comentário, um erro ou uma observação? Avise-nos; isso ajuda a melhorar o guia para todos.