MacBook Pro M5 Max 128 GB: as verdadeiras medições em IA local (benchmark 2026)
Um MacBook Pro M5 Max com GPU de 40 núcleos e 128 GB de memória unificada, um protocolo escrito com antecedência, seis modelos, um documento de 16 689 tokens: aqui estão as primeiras medições públicas em francês sobre o maior notebook da Apple para IA local. As medições foram realizadas por Joël Ramat, consultor de cibersegurança e GRC, em sua própria máquina, a nosso pedido e segundo nosso protocolo. Todos os números são as saídas brutas do Ollama, sem alterações.
Você está escolhendo uma máquina? Nossas escolhas por orçamento →
O MacBook Pro M5 Max está em estoque hoje: MacBook Pro M5 Max — 36 GB / 2 TB.
Por que essa escolha? Nossa ficha completa sobre MacBook Pro M5 Max — 36 GB / 2 TB →
Compare todas as opções por orçamento, de 800 a 3 500 € →
Em deslocamento: qual notebook para IA local →
Links afiliados — comissão possível sem custo adicional para você. Como Parceiro Amazon, QualLLM obtém lucro com compras que atendem às condições exigidas.
#A máquina e o protocolo
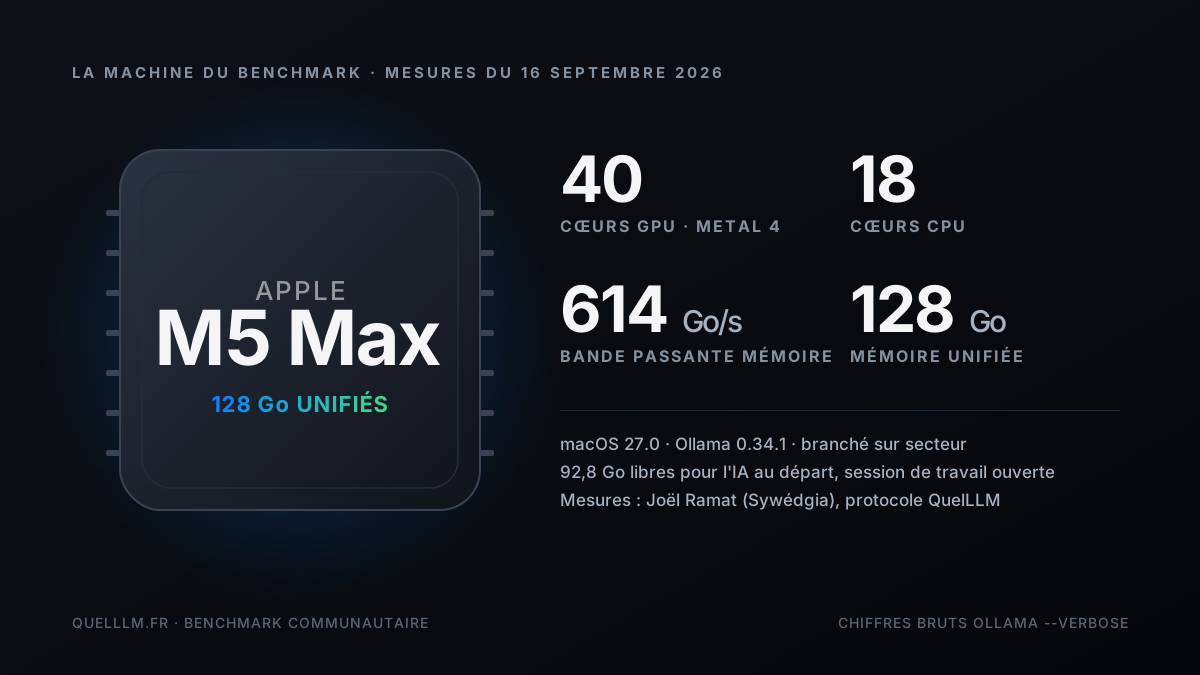
A máquina é um MacBook Pro de 16 polegadas com o chip M5 Max completo: 18 núcleos de CPU, 40 núcleos de GPU e 128 GB de memória unificada com largura de banda anunciada de 614 GB/s. Ela roda macOS 27.0 com Ollama 0.34.1. Nenhum parâmetro do sistema foi modificado: o limite de memória da GPU é o padrão, o que importa ao comparar com seu próprio Mac.
O protocolo se resume a quatro regras, e elas não são decorativas. Mac conectado à tomada, porque o macOS limita o desempenho do chip quando funciona com bateria. Aplicativos pesados fechados. Apenas um modelo carregado de cada vez. E, sobretudo, o mesmo prompt para todas as séries, pois é ele que torna os números comparáveis entre modelos e, amanhã, entre máquinas.
- Série A, as duas referências
- Gemma 4 12B e Qwen 3.8 27B em GGUF, dois modelos que também rodam em Macs bem mais modestos. Eles permitem situar a máquina em uma escala conhecida.
- Série B, MLX versus GGUF
- O mesmo Qwen 3.8 27B, com os mesmos pesos, servido pelo motor MLX do Ollama em vez de llama.cpp. Apenas o motor muda.
- Série C, o verdadeiro destaque da faixa de 128 GB
- gpt-oss 120B, 65 GB, um modelo que simplesmente não cabe em um notebook PC.
- Série D, o pré-preenchimento com carga real
- Um documento de 16.689 tokens enviado de uma só vez ao gpt-oss 120B, com uma instrução para produzir uma síntese. É a única medição significativa de prefill da campanha.
- Dois bônus fora do protocolo
- Joël já tinha Qwen 3.6 35B-A3B em MLX e gpt-oss 20B na sua máquina. Ele os mediu nas mesmas condições.
#Todos os números em uma tabela
IA local no seu Mac, a fundo: memória unificada, MLX vs GGUF, o modelo certo para seu chip, Ollama e LM Studio ajustados para Apple Silicon.
- Espaço online vitalício
- PDF + arquivos
- Atualizações vitalícias
Aqui estão as saídas brutas do comando ollama run --verbose, como Joël copiou após cada medição. Cada modelo gerou uma resposta completa ao prompt de 300 palavras, em modo de raciocínio quando o modelo o suporta, o que explica os 1.400 a 3.200 tokens gerados para 300 palavras de texto final.
| Modelo | Motor | Tamanho do modelo | Geração | Tokens gerados | Duração total |
|---|---|---|---|---|---|
| Gemma 4 12B | GGUF Q4 | 7,6 GB | 58,1 tok/s | 1 390 | 24 s |
| Qwen 3.8 27B | GGUF Q4 | 17 GB | 36,6 tok/s | 2 517 | 69 s |
| Qwen 3.8 27B | MLX | 18 GB | 68,0 tok/s | 2 103 | 31 s |
| Qwen 3.6 35B-A3B (bônus) | MLX | 23 GB | 167,2 tok/s | 3 205 | 19 s |
| gpt-oss 20B (bônus) | MXFP4 | 13 GB | 113,4 tok/s | 2 199 | 19 s |
| gpt-oss 120B | MXFP4 | 65 GB | 79,1 tok/s | 669 | 8,5 s |
| gpt-oss 120B, nova execução 1 | MXFP4 | 65 GB | 77,5 tok/s | 732 | 12,5 s |
| gpt-oss 120B, reexecução 2 | MXFP4 | 65 GB | 75,5 tok/s | 1 707 | 22,7 s |
| gpt-oss 120B, série D | MXFP4 | 65 GB | 67,6 tok/s | 2 584 | 50 s |
| Série | Tokens de prompt | Prefill | Tempo até a primeira palavra |
|---|---|---|---|
| A, B, C (prompt curto) | 43 à 98 | 31 a 346 tok/s | 0,1 a 0,9 s: latência de inicialização, não um throughput |
| D, documento de 16.689 tokens | 16 689 | 1 388 tok/s | 12,0 s |
#Geração: seis modelos, uma leitura
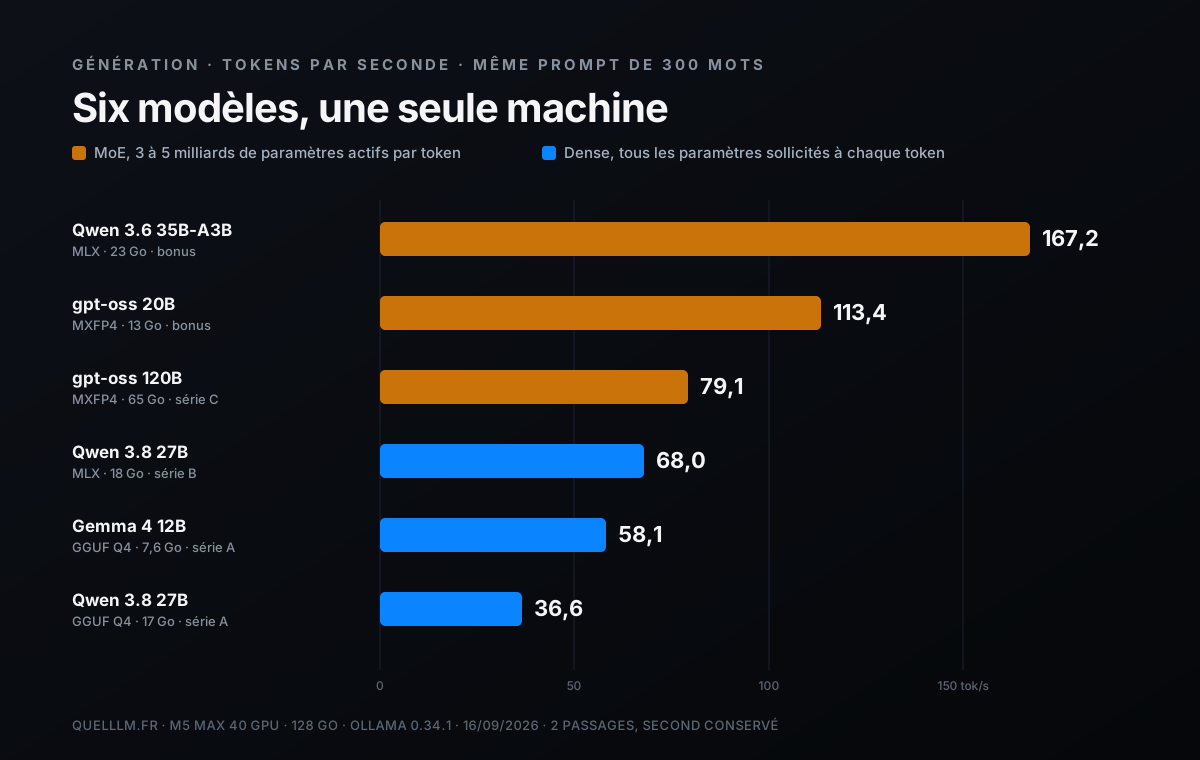
Se analisado de forma superficial, esse ranking é absurdo: um modelo de 120 bilhões de parâmetros a 79 tokens por segundo, duas vezes mais rápido que um 27B em GGUF. A explicação cabe em três letras. gpt-oss 120B, gpt-oss 20B e Qwen 3.6 35B-A3B são modelos com mistura de especialistas, MoE. A cada token, apenas uma fração dos parâmetros é acionada: cerca de 5 bilhões para gpt-oss 120B, 3,6 bilhões para gpt-oss 20B e 3 bilhões para o Qwen. A velocidade de geração depende do que se move na memória a cada token, não do que está em repouso.
Os modelos densos, Gemma 4 12B e Qwen 3.8 27B, utilizam todos os seus parâmetros a cada token. Sua velocidade segue, portanto, a largura de banda da memória dividida pelo peso do modelo: essa é a regra dos Macs desde o M1, e o M5 Max não escapa dela. Nesta máquina, um modelo denso de 27B em GGUF roda a 37 tokens por segundo, e um 12B, a 58.
- 167 tok/s em Qwen 3.6 35B-A3B com MLX
- O número mais alto da campanha, no modelo que combina os dois aceleradores: arquitetura MoE e motor MLX. É a velocidade de um pequeno 8B, com o conhecimento geral de um 35B.
- 113 tok/s em gpt-oss 20B
- O melhor equilíbrio entre velocidade, qualidade e peso para uso diário como assistente: 13 GB, uma resposta de 2.200 tokens em 19 segundos.
- 79 tok/s em gpt-oss 120B
- O modelo mais capaz da lista, com velocidade duas vezes superior à leitura humana. Esse é o resultado que justifica o nível de 128 GB, voltaremos a isso mais adiante.
- 58 e 37 tok/s nos modelos densos
- Gemma 4 12B e Qwen 3.8 27B em GGUF: desempenho confortável, mas sem surpresas. São as mesmas ordens de grandeza observadas em um M4 Max, pois a largura de banda mudou pouco entre as duas gerações.
#MLX contra GGUF, nas mesmas condições
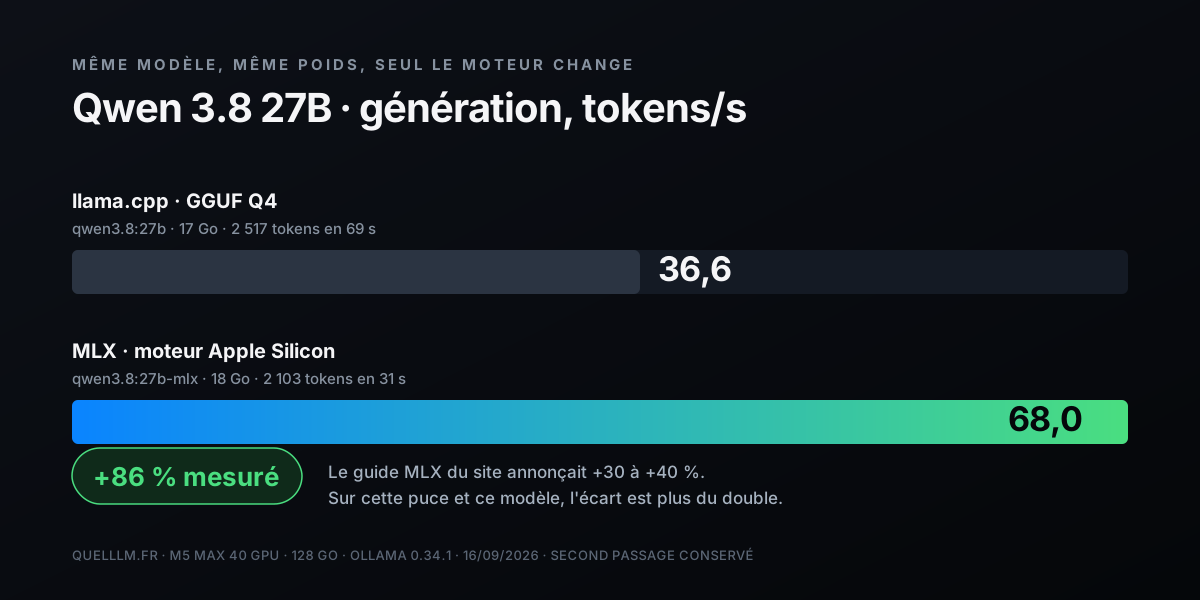
Todo mundo afirma que o MLX, a biblioteca da Apple otimizada para Apple Silicon, é mais rápido que o llama.cpp. Pouquíssimas pessoas medem isso em condições rigorosamente iguais, com o mesmo modelo, no mesmo dia e na mesma máquina. É isso que a série B faz: Qwen 3.8 27B em GGUF Q4 a 36,6 tokens por segundo, depois Qwen 3.8 27B em MLX a 68,0 tokens por segundo. Um aumento de 86%.
Nosso guia sobre MLX e o Mac M5 anunciava um ganho de 30 a 40% na geração. No M5 Max e neste modelo, a realidade é mais do dobro. Parte dessa diferença provavelmente vem das otimizações do MLX próprias da geração M5 e dos aceleradores neurais integrados à GPU; ainda não conseguimos isolar sua contribuição. O que podemos dizer é que, em um Mac recente, rodar um modelo denso em GGUF enquanto existe sua versão MLX equivale a deixar metade da máquina na garagem.
#O que 128 GB realmente permitem
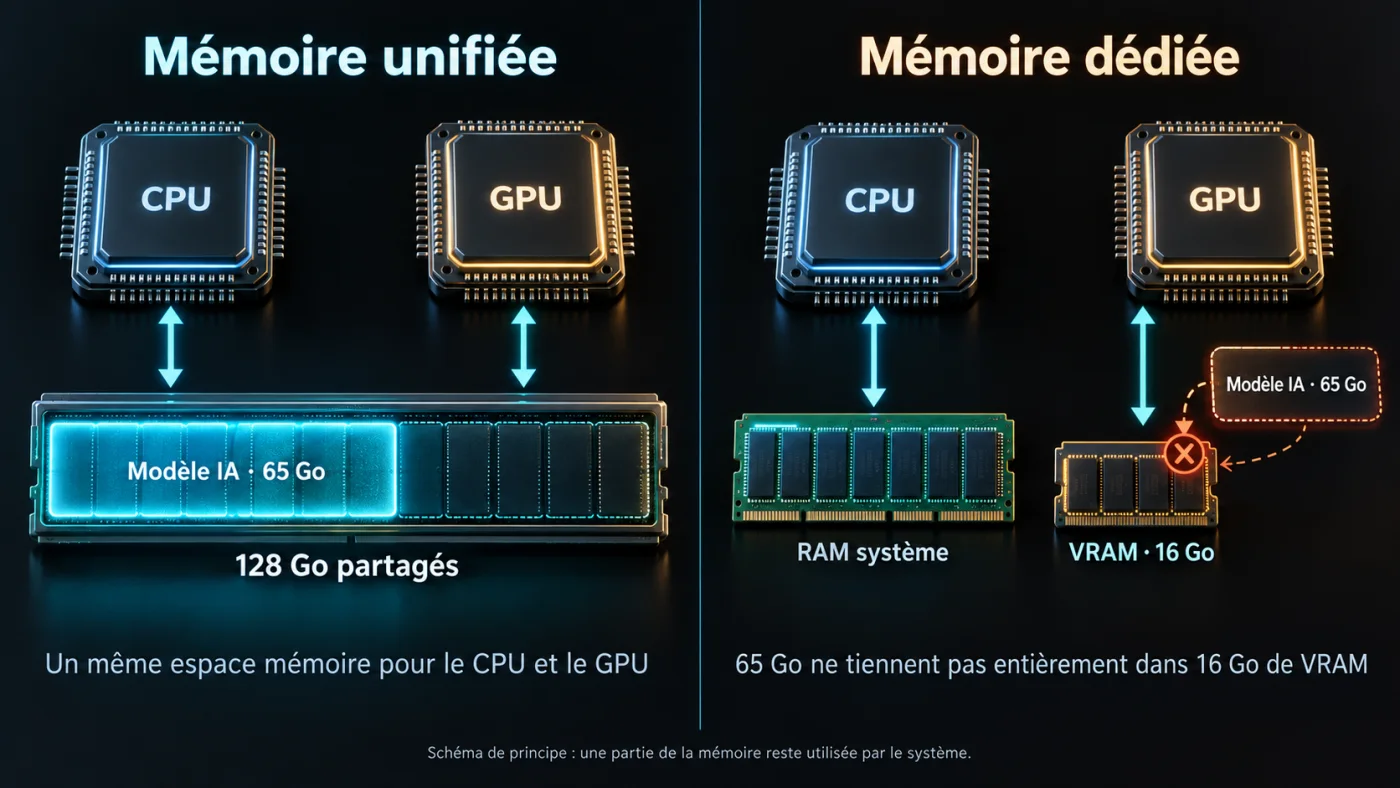
O que realmente importa na faixa de 128 GB não é a velocidade, mas o que cabe na memória. gpt-oss 120B ocupa 65 GB em MXFP4. Nenhum notebook PC consegue executá-lo na GPU: as placas gráficas para notebooks têm um limite de 16 ou 24 GB de VRAM. No M5 Max com 128 GB, ele é carregado, responde entre 75 e 79 tokens por segundo em três execuções e ainda sobra espaço.
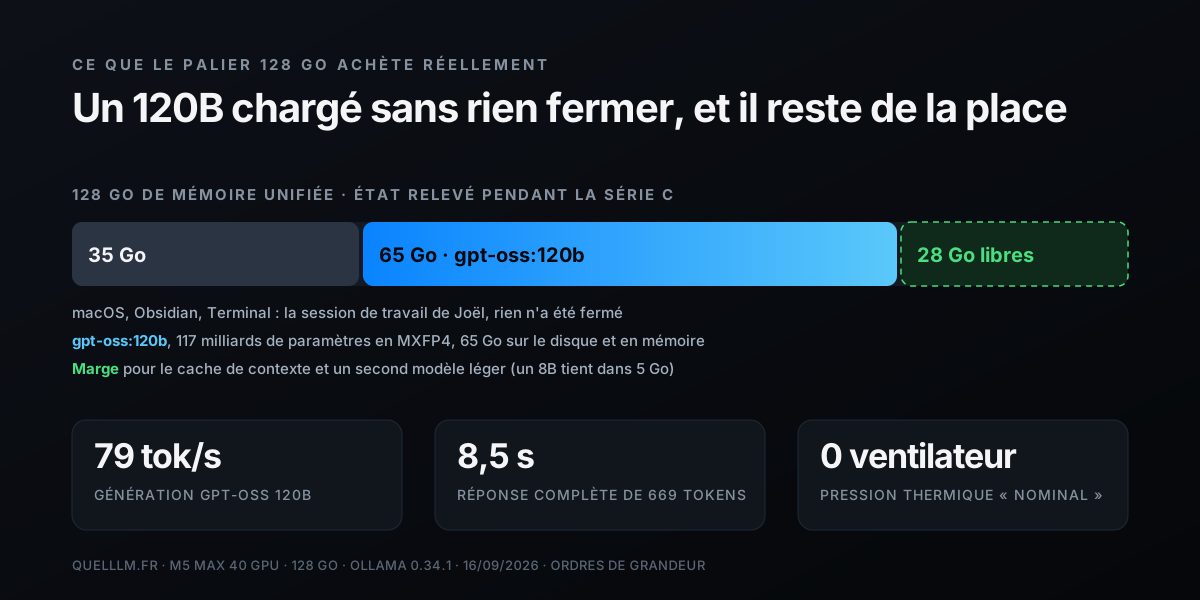
O levantamento de memória feito antes da campanha é revelador: 35 GB ocupados pelo macOS e pelos aplicativos da sessão de trabalho, 93 GB disponíveis para a IA. O modelo de 120B cabe nessa memória com uma margem de cerca de trinta gigabytes, suficiente para manter um contexto longo e um segundo modelo leve em paralelo, como um 8B para autocompletar código. Em um M5 Max de 64 GB, o mesmo modelo não carrega de jeito nenhum; com 96 GB, ele cabe, mas sem margem para o restante.
- 8,5 a 22,7 segundos
- Duração total da resposta do gpt-oss 120B ao prompt de 300 palavras, em três execuções: 669, 732 e depois 1.707 tokens gerados. A velocidade não muda (79,1, 77,5 e 75,5 tokens por segundo); é o comprimento do raciocínio que varia de uma execução para outra, pois o modelo decide se conta ou não suas palavras uma a uma.
- 50 segundos
- Duração da série D: leitura de um documento de 16.689 tokens e, em seguida, redação de uma síntese de 2.584 tokens em dez itens.
- Pressão térmica « Nominal »
- Medição feita após cada série. Nenhum ventilador audível durante toda a campanha de testes, incluindo o modelo de 120B.
#O prefill, o número que ninguém publica
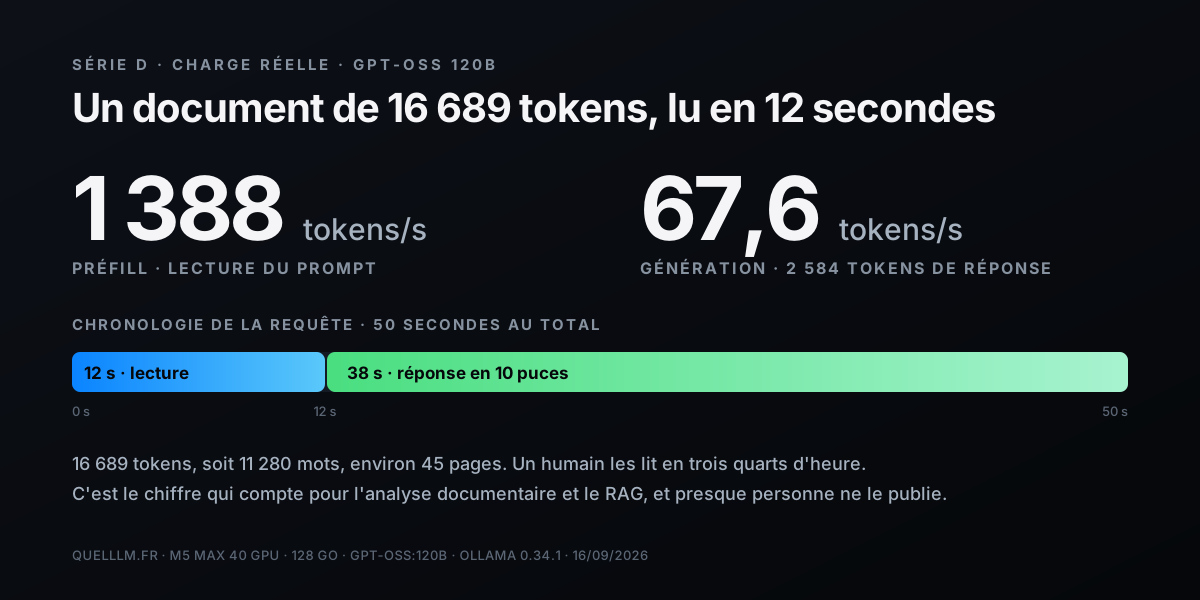
Um prompt de vinte palavras não diz nada sobre o prefill. Para medi-lo, Joël enviou ao gpt-oss 120B um texto de 11.280 palavras em um único bloco, ou seja, 16.689 tokens e cerca de 45 páginas, com uma instrução de resumo. Resultado: 1.388 tokens por segundo na leitura, ou seja, doze segundos antes que a primeira palavra da resposta aparecesse, seguidos de 2.584 tokens de síntese a 67,6 tokens por segundo.
Esse é o número que faz sentido para usos sérios. Analisar um contrato, resumir um relatório de auditoria, consultar uma base documental com RAG: em todos esses casos, o modelo passa a maior parte do tempo lendo, não escrevendo. Doze segundos para 45 páginas, em um notebook, sem que um único byte saia da máquina, é o que torna a IA local utilizável para um consultor sujeito ao sigilo profissional ou uma empresa sujeita a exigências de confidencialidade.
#Calor e ventoinhas
Joël registrou o estado térmico após cada série usando o comando de pressão térmica do macOS. O resultado foi sempre “Nominal”, sem ruído audível das ventoinhas, inclusive durante a série D, que utiliza a GPU em plena carga durante cinquenta segundos. Isso é coerente com o que observamos nos M4 Max, com uma ressalva: nossas medições são feitas em períodos curtos de menos de um minuto. O teste de throttling previsto no protocolo, dez minutos de carga contínua seguidos de uma nova medição da série A, não foi realizado. Vamos solicitá-lo na próxima campanha.
#O que essas medições não dizem
Um benchmark honesto lista o que não prova. Aqui estão as ressalvas, na ordem de importância.
- Pré-preenchimentos de prompts curtos
- Duas execuções por modelo, com a segunda mantida. Mas prompts de 43 a 98 tokens medem apenas a latência de inicialização: somente a série D, com 16.689 tokens, fornece uma taxa real de leitura.
- Nenhum modelo denso de 70 bilhões
- O nível de 128 GB também se justifica com os 70B em Q4 com contexto longo. Não medido aqui.
- Sem teste de throttling
- Picos de carga de menos de um minuto. O comportamento durante uma hora de RAG intensivo ainda precisa ser documentado.
- Sem medições com alimentação pela bateria
- O protocolo exige que o computador esteja conectado à tomada. Na bateria, espere números significativamente inferiores, pois o macOS limita o chip.
- Um documento da série D específico de cada testador
- O texto longo enviado na série D não é definido pelo protocolo: dois testadores não leem o mesmo documento, o que limita a comparação do prefill entre máquinas. Por sugestão de Joël, o protocolo agora fornece um único texto de referência de 11.292 palavras, disponível para download na seção seguinte: as próximas medições serão comparáveis entre si. A medição desta página foi feita antes, com outro documento de tamanho equivalente.
- Uma única máquina, um único operador
- Nenhuma variância medida. Se você tiver a mesma configuração, suas medições são bem-vindas; veja a seção seguinte.
- Modelos em modo de raciocínio
- Os modelos que refletem antes de responder geram muito mais tokens do que as 300 palavras solicitadas, e essa extensão varia de uma execução para outra para um mesmo modelo (669 a 1.707 tokens no gpt-oss 120B). Portanto, os tempos totais não são comparáveis; apenas as velocidades são.
- Cache de prompt nas novas execuções
- Quando o mesmo prompt é executado novamente, o Ollama reutiliza os tokens já lidos (« prompt eval cached »). O prefill de uma nova execução com o mesmo prompt não é, portanto, uma medição; para medir o prefill, é necessário um prompt longo e novo, como na série D.
#Reproduzir o benchmark em sua casa
O protocolo foi projetado para ser executado exatamente da mesma forma em qualquer Mac com Apple Silicon, do MacBook Air ao Mac Studio. Se você seguir as mesmas séries com o mesmo prompt, seus resultados serão diretamente comparáveis aos apresentados nesta página.
- 01Preparar a máquinaConecte o computador à tomada, feche o navegador, o Docker e as máquinas virtuais. Anote o modelo do chip, o número de núcleos do GPU e a versão do Ollama.
- 02Registrar o estado do sistemaAnote o chip, o número de núcleos da GPU, as versões do macOS e do Ollama, a alimentação elétrica, a memória disponível e os aplicativos abertos. Joël escreveu um script zsh que gera esse relatório com um único comando; ele será incluído no capítulo de benchmarks do kit Mac após verificação, com a autorização de Joël.
- 03Série ABaixe gemma4:12b e qwen3.8:27b, inicie cada um com --verbose, cole o prompt comum, deixe a resposta terminar, saia com /bye. Faça duas rodadas e mantenha a segunda.
- 04Série BFaça o mesmo com qwen3.8:27b-mlx. Compare a linha eval rate com a da série A.
- 05Série CSe você tiver 96 GB ou mais: gpt-oss:120b. Caso contrário, escolha o maior modelo que caiba na sua memória unificada, reservando 10 GB.
- 06Série DBaixe o texto de referência QuelLLM, com 11 292 palavras, o mesmo para todos, e passe-o para ollama run, seguido da instrução « Resuma este texto em 10 itens de lista ». Anote o número de tokens do prompt exibido: ele depende do modelo, não do texto.
#Para quem e a que preço
O M5 Max de 128 GB se justifica por um único uso: rodar localmente modelos que não cabem em nenhum outro notebook, com margem para o contexto e um segundo modelo. Com gpt-oss 120B a 79 tokens por segundo e um documento de 45 páginas lido em doze segundos, sem ventilador, é uma estação de trabalho de IA que cabe em uma bolsa.
| Você é | O que esse benchmark informa a você | Nível recomendado |
|---|---|---|
| Consultor, advogado ou contador sujeito a sigilo profissional | Um 120B lê e sintetiza seus documentos localmente, a uma velocidade viável para uso, sem enviar nada para fora | M5 Max 128 GB |
| Desenvolvedor que quer um copiloto local sério | gpt-oss 20B ou Qwen 3.6 35B-A3B são mais do que suficientes e cabem em 48 GB. Os nossos 113 e 167 tok/s se referem ao chip com 40 núcleos de GPU: a memória é suficiente, a velocidade será inferior em uma variante com menor largura de banda | M5 Max 48 ou 64 GB |
| Usuário diário de um assistente de redação | Um modelo denso de 12B ou um MoE de 20B atende a esse uso; a versão de 128 GB é um luxo. A memória é suficiente, mas a do M5 Pro é mais lenta: espere velocidades inferiores aos nossos 58 e 113 tok/s | M5 Pro 48 GB |
| Equipe que quer um servidor compartilhado | O Mac Studio M5 Max ou Ultra oferece o mesmo motor de processamento com mais memória e um sistema de refrigeração de computador de mesa | Mac Studio |
Se suas necessidades se limitam a modelos de 30 bilhões de parâmetros, metade da memória é suficiente e a diferença de preço paga um monitor muito bom. Se suas necessidades começam em modelos de 100 bilhões, não existe alternativa portátil, e este guia fornece os números para justificar essa escolha a quem assina a ordem de compra.
#Créditos e fontes
As medições desta página foram realizadas por Joël Ramat, consultor de cibersegurança e GRC, especialista em ISO 27001, com atuação em consultoria e auditoria potencializadas por IA on-premise, cofundador e presidente da Sywédgia SAS. Ele executou o protocolo QuelLLM em sua própria máquina em 16 de setembro de 2026 e revisou este artigo antes da publicação. Os dados coletados continuam sendo dele, e ele tem liberdade para publicá-los por conta própria.
- Joël Ramat no LinkedIn
- Sywédgia, consultoria e auditoria de cibersegurança
- Nosso guia de comparação entre MLX e llama.cpp no Mac M5
- Ficha de hardware MacBook Pro M5 Max
- Instalar gpt-oss com Ollama
Método: saídas brutas de ollama run --verbose copiadas após cada medição, sem edição; estado do sistema registrado por script antes da campanha; pressão térmica lida após cada série. O relatório completo, com as respostas integrais dos modelos, é conservado e pode ser fornecido por solicitação. Redação e formatação: Mohamed Meguedmi, QualLLM.
#FAQ
O M5 Max 128 GB é mais rápido que o M4 Max 128 GB em IA local?+
Por que o gpt-oss 120B é mais rápido que o Qwen 3.8 27B?+
São necessários 128 GB para rodar o gpt-oss 120B?+
Esses números valem quando o computador está funcionando apenas com a bateria?+
Por que os prefills das séries A, B e C não são publicados?+
Posso enviar minhas próprias medições?+
Onde encontrar o script de preparação usado para este benchmark?+
Um comentário, um erro ou uma observação? Avise-nos; isso ajuda a melhorar o guia para todos.