Assistente de IA privado para PMEs no GB10: mesures
Em um GIGABYTE AI TOP ATOM (chip NVIDIA GB10, 128 GB), uma stack de software completa (a interface Open WebUI, o modelo gpt-oss 120B e o modelo de busca bge-m3) inicializa em 66 segundos e ocupa 68 GB. Ela indexa 5.000 páginas em 6 minutos, encontra o documento certo em 86% dos casos com 500 páginas (78% com 5.000) e responde a uma pessoa em 10 segundos. Durante 200 respostas, nenhum contêiner enviou pacotes para fora. Cada resposta custa 0,15 Wh na GPU.
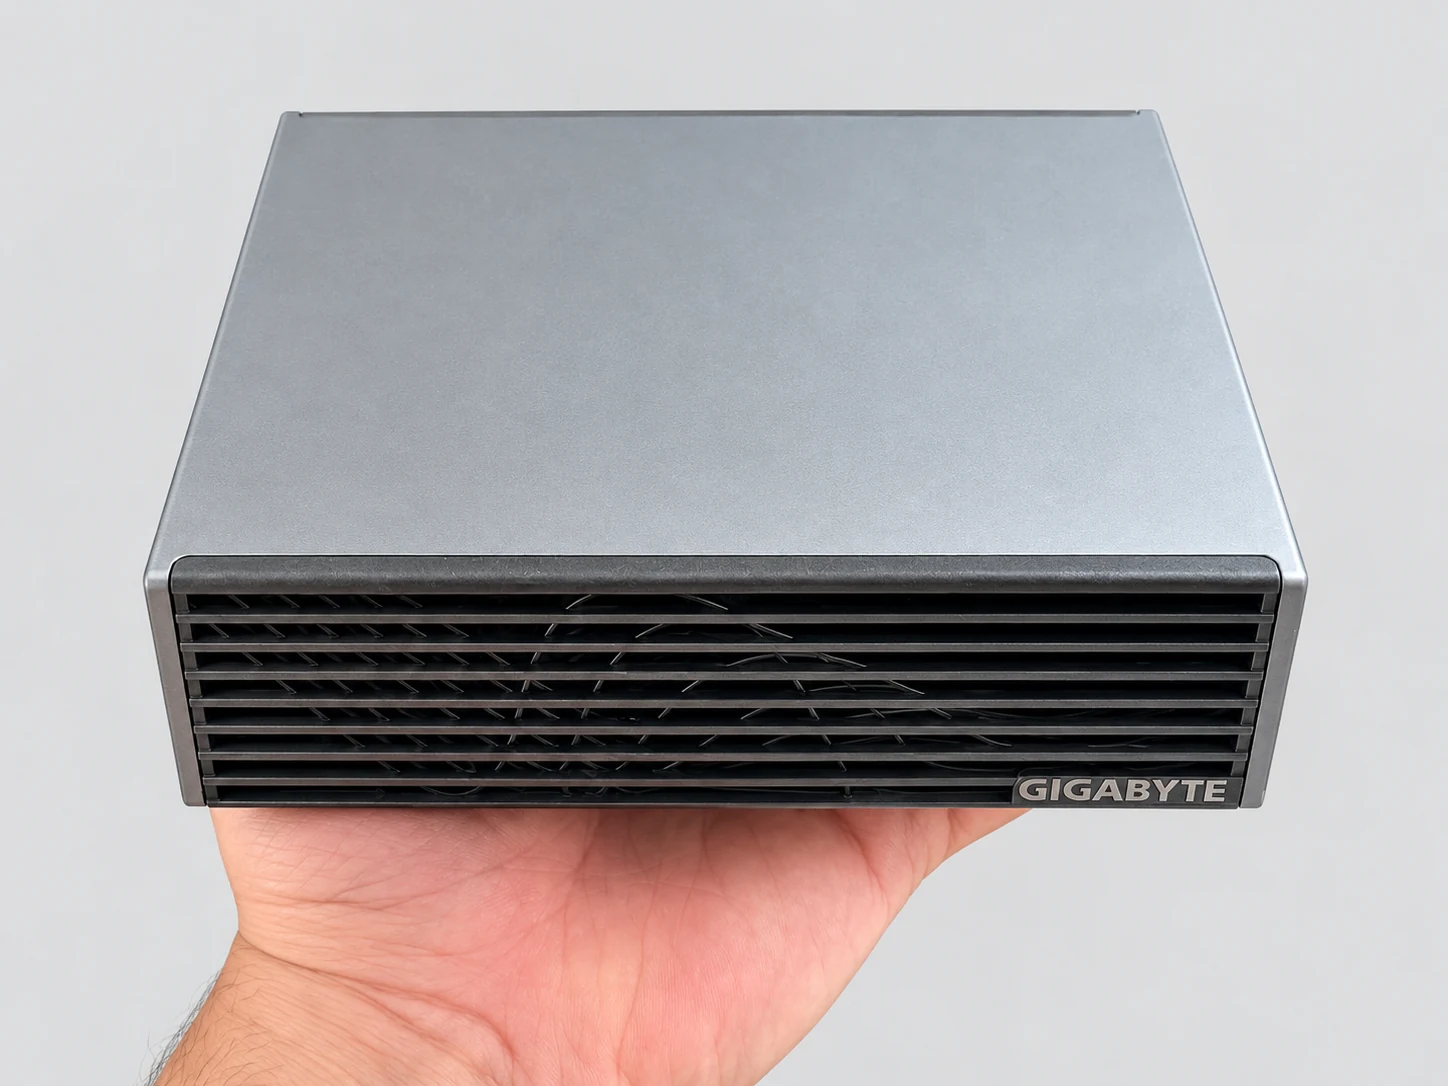
Uma PME que quer consultar seus contratos e procedimentos com uma IA logo se pergunta: para onde vão meus documentos? Um assistente privado mantém tudo em uma máquina do escritório. Ele se baseia em RAG (geração aumentada por recuperação): o sistema primeiro busca os trechos úteis nos seus arquivos, depois um modelo redige a resposta. Medimos uma stack completa em um AI TOP ATOM fornecido gratuitamente pela GIGABYTE, com os documentos de uma empresa fictícia.
#O que a stack contém: três softwares, 68 GB
Um assistente privado é composto de três componentes, que instalamos em contêineres Docker em um AI TOP ATOM (modelo ATAGB10-9000, DGX OS 7.5.0). Os modelos rodam com llama.cpp, build 11430.
- Open WebUI 0.11.4
- A interface web: contas, importação de arquivos, bases de conhecimento e conversa. É também ela que divide os documentos em trechos, de 1.000 caracteres com 100 de sobreposição por padrão, e que mantém os 5 trechos mais próximos de cada pergunta.
- gpt-oss 120B (MXFP4)
- O modelo que redige a resposta, servido pelo llama-server (o servidor fornecido com o llama.cpp). MXFP4 é seu formato original, já compactado. Ele está configurado para 10 solicitações em paralelo. É um modelo MoE (mistura de especialistas): a cada token, ele usa apenas 5,1 dos seus 117 bilhões de parâmetros.
- bge-m3 (Q8_0)
- O modelo de embeddings, usado aqui na versão Q8_0 (quantização de 8 bits). Ele transforma cada trecho em uma sequência de números que representa seu significado, o que permite comparar uma pergunta com os trechos. Ele é multilíngue e, portanto, adequado ao francês.
A inicialização completa, com o cache de disco esvaziado, levou 66 segundos até a interface ficar pronta. A stack ocupa 68,0 GB de memória: o processo gpt-oss 120B usa 63,6 GB na GPU e o bge-m3, 0,8 GB; o restante vem do Open WebUI e do sistema.
Após a inicialização, restam 48,6 GB disponíveis na máquina. As memórias deste guia estão em GB, como o Linux as exibe: 1 GB = 1.024 MB. Nosso primeiro guia da série detalha a velocidade do gpt-oss 120B: 58 tokens por segundo.
#A empresa fictícia e as 100 perguntas
Aproveite a nossa experiência e um percurso guiado para construir o seu RAG local e trabalhar com os seus próprios documentos.
- Espaço online vitalício
- PDF + arquivos
- Reembolsado em 30 dias
A Lustrelle é uma PME fictícia que inventamos: uma oficina, um depósito, um serviço pós-venda e escritórios. Seus 60 documentos são arquivos de texto no formato Markdown (um texto simples com alguns sinais para títulos e listas). Eles tratam de recursos humanos, segurança da oficina, backups, reembolso de despesas, devoluções de clientes ou plano de treinamento. Contêm números, nomes e condições precisos, para que cada resposta possa ser verificada.
Para atingir volumes realistas, adicionamos fichas públicas do Service-Public, como prevê o nosso protocolo. Isso resulta em três bases de tamanhos crescentes. Os detalhes de método deste guia foram definidos por um aditivo ao nosso protocolo, datado de 7 de outubro de 2026, antes da primeira resposta do assistente. O protocolo foi congelado antes da primeira medição; o método, a lista datada dos aditivos e os dados das nossas tabelas estão publicados na nossa página de metodologia.
| Base | Arquivos | Conteúdo |
|---|---|---|
| 50 páginas | 26 | 26 dos 60 documentos da Lustrelle |
| 500 páginas | 114 | os 60 documentos da Lustrelle e 54 fichas do Service-Public |
| 5.000 páginas | 701 | os 60 documentos da Lustrelle e 641 fichas do Service-Public |
As 100 perguntas são feitas exatamente como estão, sem reformulação. 80 delas têm resposta nos documentos: 50 perguntas de fato, 10 de procedimento, 10 de número e 10 de síntese. 20 não têm nenhuma resposta nos documentos: servem para verificar se o assistente admite isso em vez de inventar.
- Fait
- Quantos brigadistas de primeira intervenção contra incêndio nós temos? Resposta esperada: dez, designados entre os funcionários.
- Chiffre
- Quanto custa, com impostos (TTC), o pendente Brindille de 60 cm em carvalho defumado? Resposta esperada: 360 € TTC (348 € em carvalho natural, mais 12 € pelo acabamento defumado).
- Sem resposta nos documentos
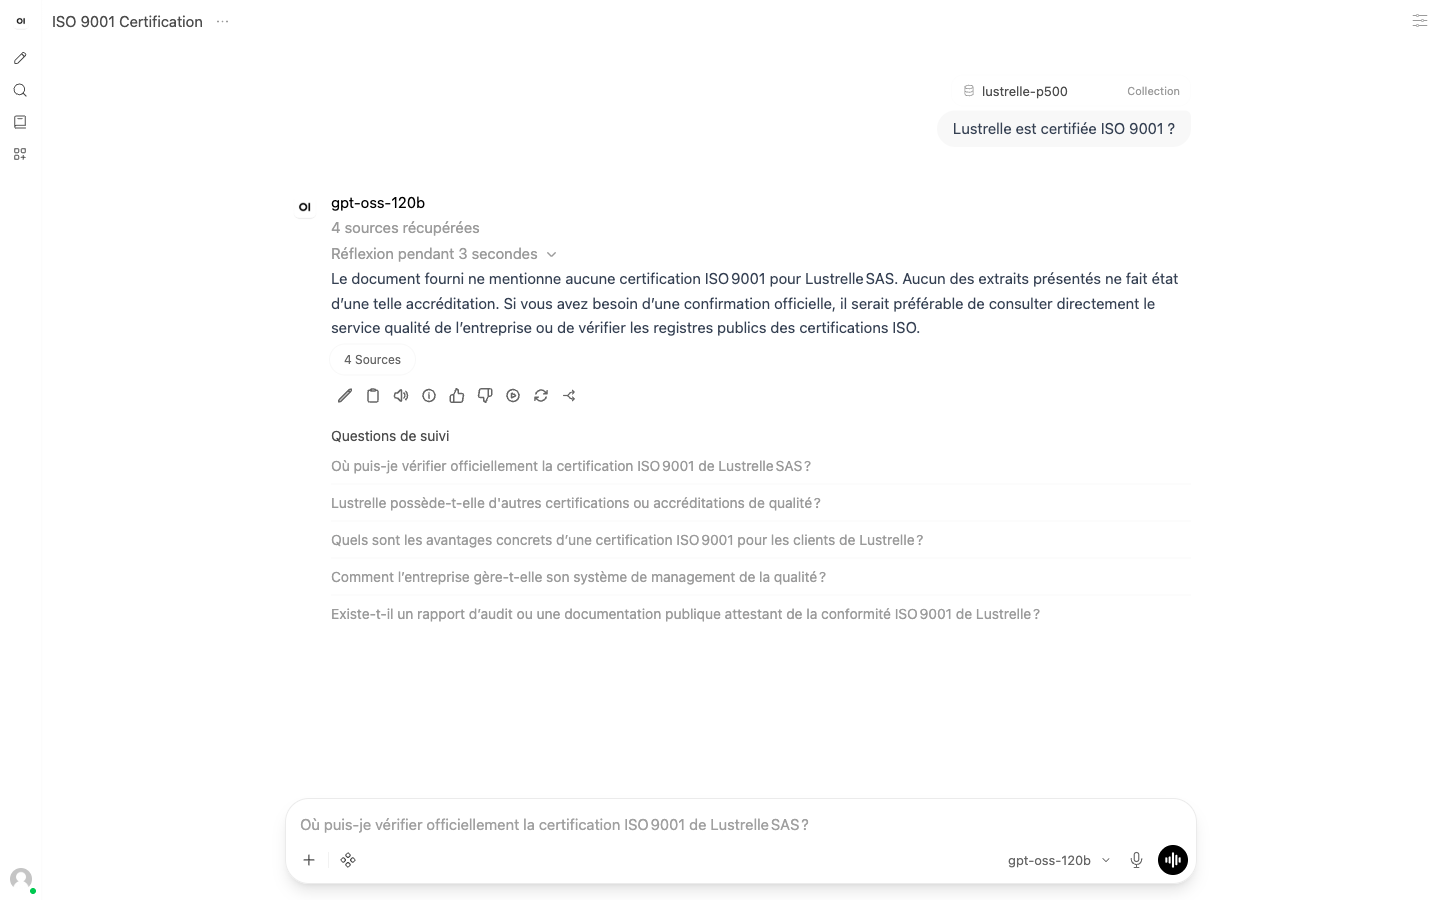
- A Lustrelle tem certificação ISO 9001? Resposta esperada: o assistente diz que os documentos não mencionam isso.
#Montar a stack: os comandos
A stack cabe em três contêineres e duas redes Docker. A primeira rede é “interna”: o Docker não dá a ela nenhum acesso ao exterior. Os dois servidores de modelos estão conectados somente a ela. O Open WebUI está conectado a essa rede interna, para se comunicar com os modelos, e a uma segunda rede, pela qual você abre a interface no navegador.
Os comandos abaixo são os dos nossos testes de 7 e 8 de outubro de 2026, com caminhos simplificados. O llama.cpp (build 11430) é compilado na máquina para o chip GB10; o comando de compilação está no tutorial 70B desta série.
A opção -np 10 abre 10 slots: dez requisições podem avançar ao mesmo tempo (o guia do llama.cpp da NVIDIA prevê 4 por padrão). A opção -c 131072 define o contexto total, compartilhado entre os slots. RAG_TOP_K em 5 solicita cinco trechos por pergunta. As variáveis OFFLINE_MODE, ANONYMIZED_TELEMETRY, DO_NOT_TRACK e SCARF_NO_ANALYTICS desativam as verificações de atualização, os downloads da internet e a telemetria do Open WebUI. A divisão em trechos continua sendo a padrão do Open WebUI, ajustável na interface dele.
- 01Abra o Open WebUIAcesse http://127.0.0.1:3100 e crie a conta de administrador. Escolha o gpt-oss-120b como modelo.
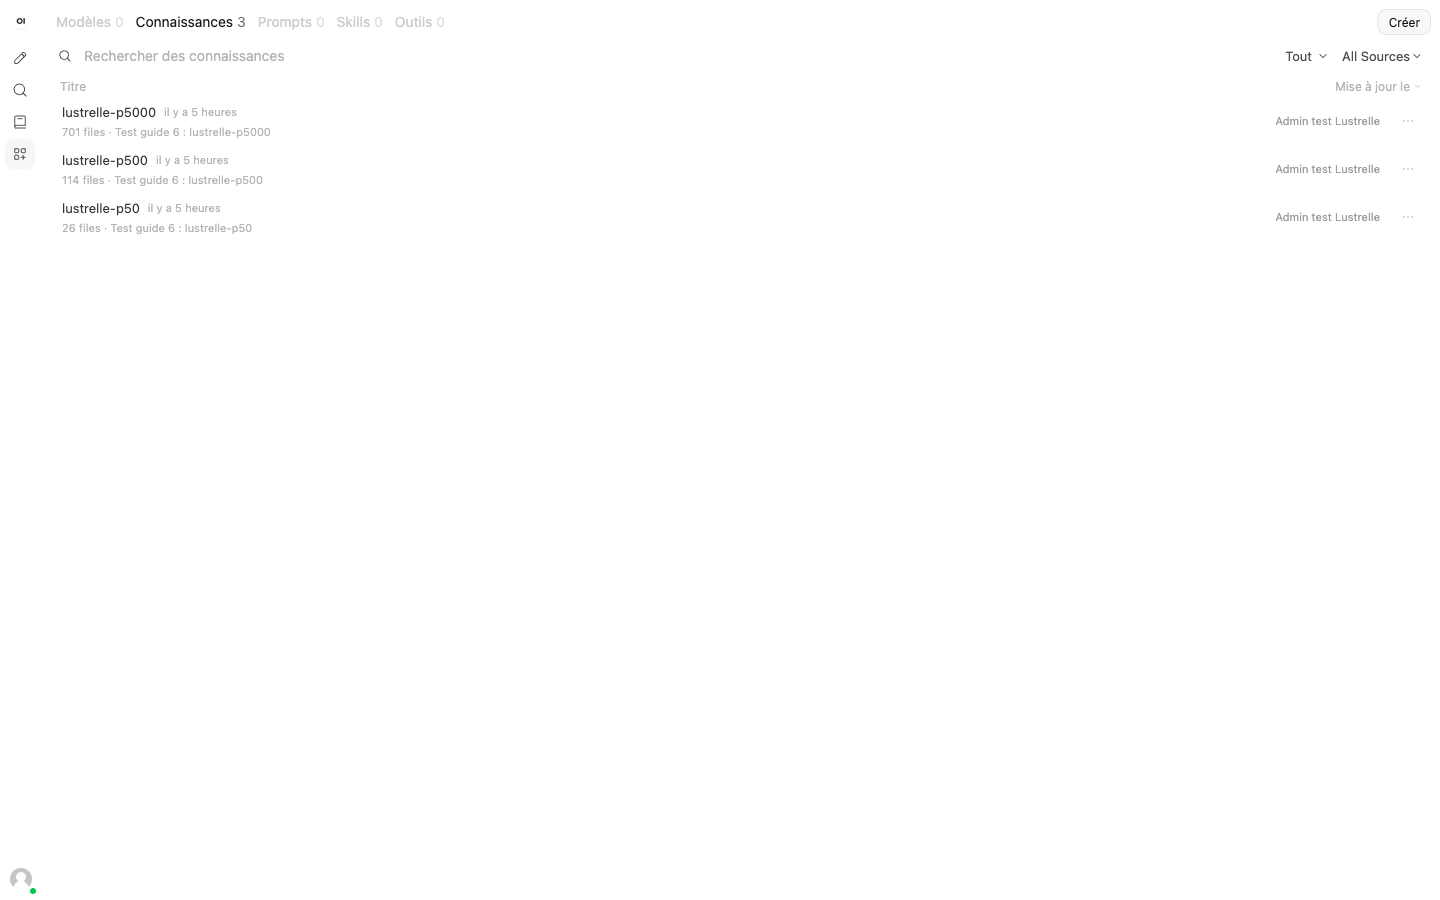
- 02Crie uma base de conhecimentoAbra a seção Conhecimento, crie uma base e adicione seus arquivos. O Open WebUI lê cada arquivo, divide-o em trechos e calcula os embeddings.
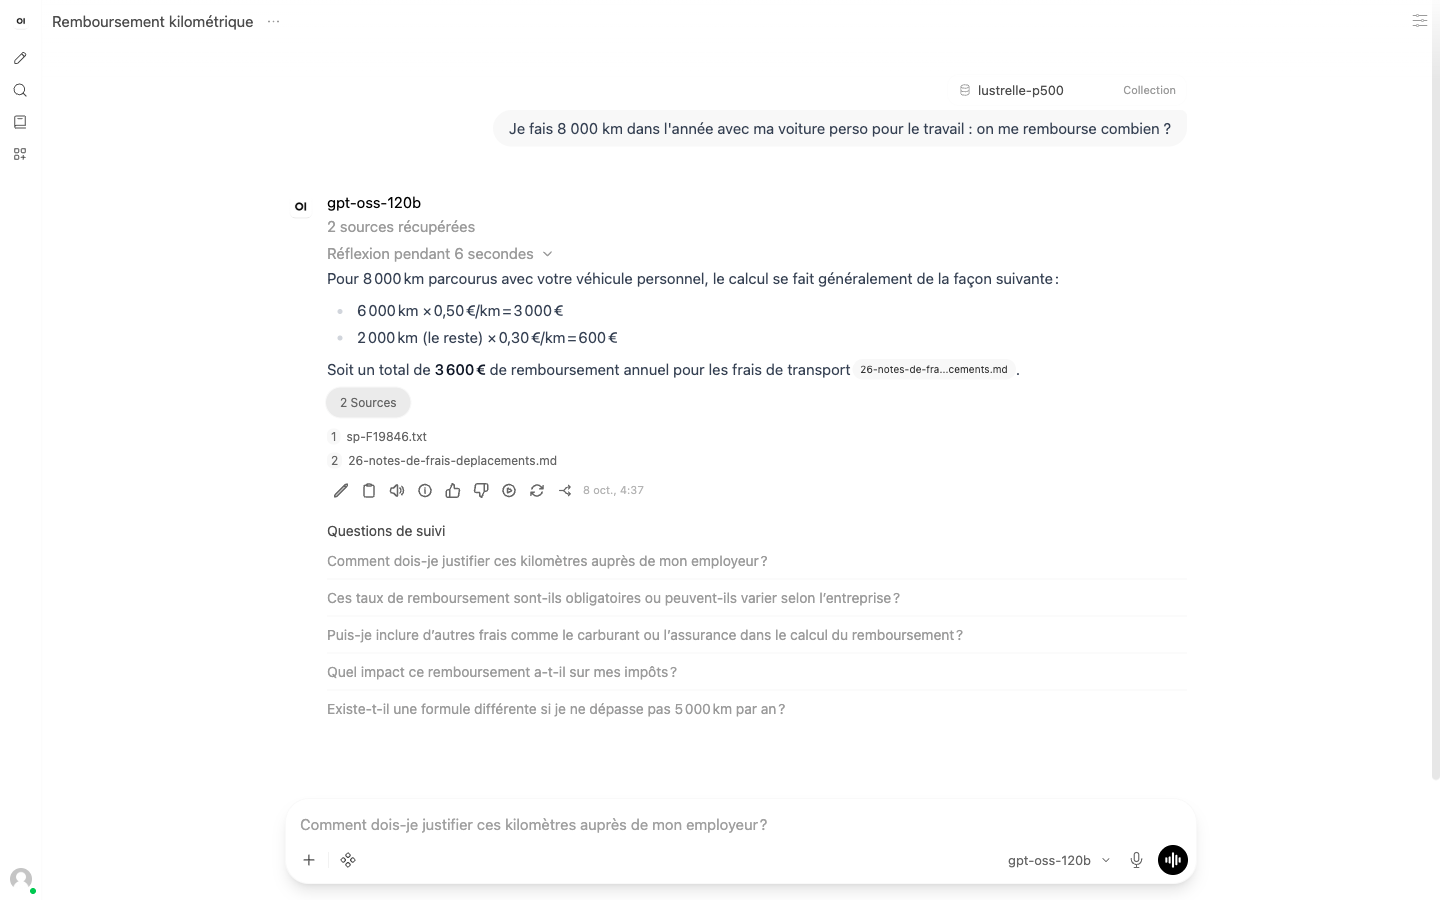
- 03Consulte a baseEm uma conversa, digite o sinal de cerquilha seguido do nome da base e depois faça sua pergunta. A resposta aparece com as fontes.
Nossas medições passam pela API do Open WebUI, o que permite reproduzi-las por script. Aqui estão as mesmas chamadas do nosso script de medição (escrito em Python), transcritas com curl e jq.
#Indexar 50, 500 e 5.000 páginas
Indexar é ler cada arquivo, dividi-lo em trechos, calcular os embeddings com o bge-m3 e armazenar tudo na base. Nosso script envia os arquivos 4 de cada vez e cronometra até o último arquivo processado. Nenhum arquivo falhou.
| Base | Arquivos | Duração | Falhas |
|---|---|---|---|
| 50 páginas | 26 | 9,2 s | 0 |
| 500 páginas | 114 | 46,8 s | 0 |
| 5.000 páginas | 701 | 365,9 s (6,1 min) | 0 |
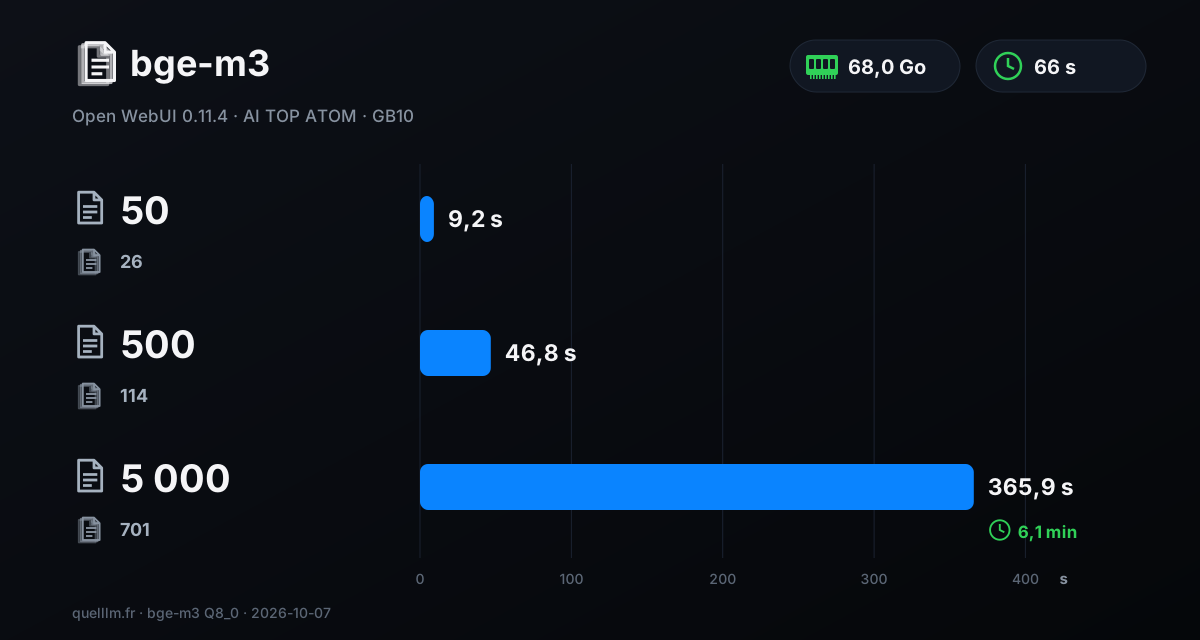
5.000 páginas ficam prontas em pouco mais de 6 minutos, ou seja, cerca de 1,9 arquivo por segundo. Reindexar um acervo de 5.000 páginas leva, portanto, menos de 7 minutos. Durante essa indexação, a GPU consumiu 5,4 Wh.
#O documento certo é encontrado?
Antes da qualidade das respostas, é preciso saber se o assistente busca no lugar certo. Nosso indicador automático, "documento certo encontrado", conta as perguntas para as quais pelo menos um dos documentos esperados aparece entre as fontes retornadas pelo Open WebUI. Ele abrange as 80 perguntas que têm resposta nos documentos. Um script o calcula; não é uma nota de qualidade e não diz se a resposta está correta.
| Base | Documento certo encontrado | Respostas recebidas sem erro | Tempo mediano de uma resposta |
|---|---|---|---|
| 500 páginas | 86% (69 de 80 perguntas) | 100 de 100 | cerca de 40 s |
| 5.000 páginas | 78% (62 de 80 perguntas) | 100 de 100 | cerca de 42 s |
Com cerca de seis vezes mais arquivos (701 contra 114), o documento certo continua sendo encontrado em 78% dos casos. As 100 respostas de cada base chegaram sem erro técnico nem resposta vazia, cada uma com a lista de suas fontes. Essa lista permite conferir: basta um clique no botão de fontes para ver os arquivos usados.
#Quantas pessoas ao mesmo tempo?
Simulamos 1, 5 e depois 10 usuários consultando a stack ao mesmo tempo. Eles estão em um Mac conectado ao ATOM por um túnel SSH que passa pelo Tailscale, uma rede privada. Cada usuário faz 6 perguntas seguidas, sem pausa entre uma e outra, e as respostas chegam em streaming. Registramos o tempo até a primeira palavra e o tempo até a resposta completa, em mediana. Cada série tem 6, 30 ou 60 requisições; nenhuma falhou.
| Usuários | Base | Primeira palavra | Resposta completa |
|---|---|---|---|
| 1 | 500 páginas | 9,0 s | 9,6 s |
| 1 | 5.000 páginas | 9,9 s | 10,2 s |
| 5 | 500 páginas | 33,1 s | 38,4 s |
| 5 | 5.000 páginas | 39,3 s | 44,7 s |
| 10 | 500 páginas | 52,4 s | 63,5 s |
| 10 | 5.000 páginas | 50,2 s | 64,8 s |
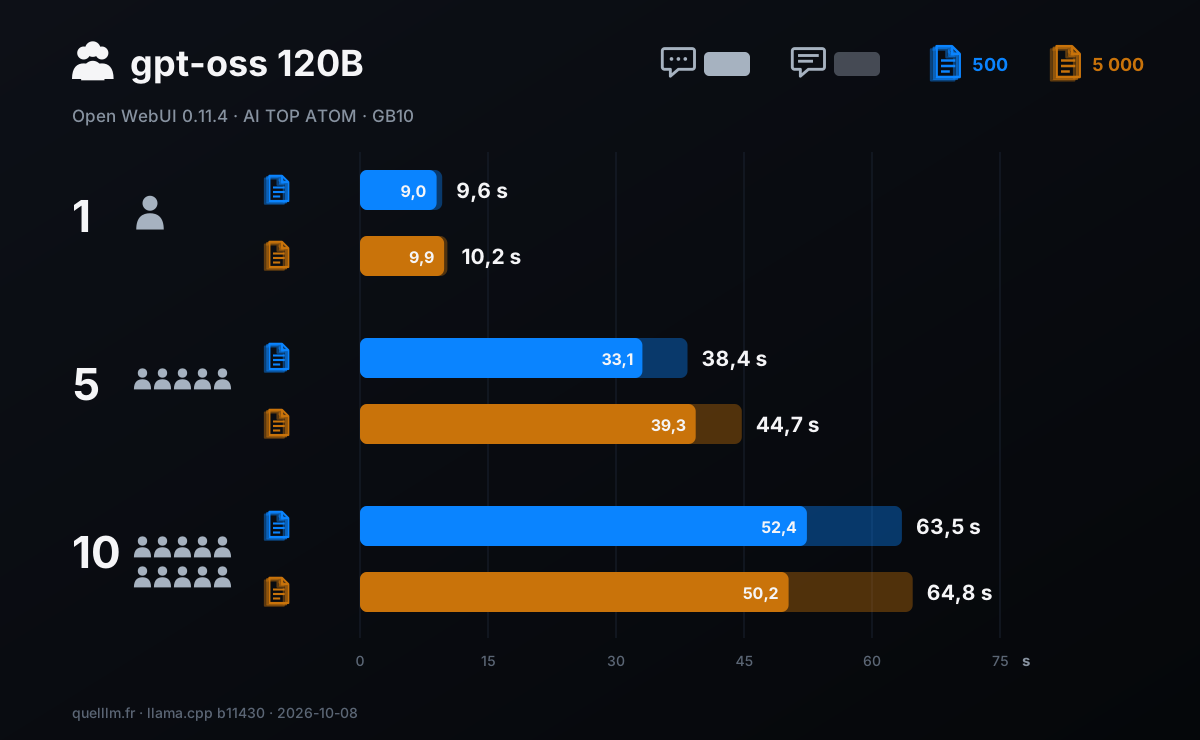
Para uma pessoa sozinha, a resposta completa chega em 9,6 s com 500 páginas e em 10,2 s com 5 000 páginas. Quando 5 pessoas fazem sua pergunta ao mesmo tempo, a mediana sobe para 38 s e 45 s. Com 10 pessoas, fica em cerca de um minuto: 63,5 s e 64,8 s. O tamanho da base pouco altera esses tempos: de 500 para 5 000 páginas, a diferença vai de 0,6 a 6,4 segundos.
A primeira palavra chega depois da fase de raciocínio do gpt-oss 120B: o Open WebUI exibe então “Raciocinou por 6 segundos” ou uma duração parecida. Essa fase se soma à leitura dos trechos e é compartilhada entre os usuários. Nosso teste é exigente: cada usuário emenda uma pergunta na outra sem tempo de leitura, enquanto uma pessoa de verdade lê a resposta antes de fazer a próxima.
#Dimensionar para 5 a 20 pessoas
Com 10 usuários ativos continuamente, a stack conclui 60 respostas em 441 segundos na base de 500 páginas: cerca de 8 respostas por minuto. Veja um cálculo a partir dessa medição. Uma equipe de 20 pessoas, em que cada uma faz em média uma pergunta a cada 5 minutos, gera 4 perguntas por minuto, ou seja, metade dessa vazão. É uma ordem de grandeza e não uma medição: seu uso real pode ser diferente.
- Até 5 pessoas
- Uma resposta em 10 s quando uma pessoa faz uma consulta; cerca de 40 s quando as 5 consultam no mesmo segundo.
- De 5 a 10 pessoas
- Cerca de um minuto para uma resposta completa quando os 10 fazem perguntas continuamente, sem nenhum erro. O servidor está configurado para 10 solicitações em paralelo.
- De 10 a 20 pessoas
- Não medimos mais de 10 usuários simultâneos. O cálculo acima sugere que 20 pessoas com uso habitual ficam abaixo da vazão medida.
#Confidencialidade: o que verificamos
Um assistente privado só faz sentido se os documentos ficarem com você. Por isso, verificamos o tráfego de rede. Durante as 200 respostas, 100 em cada base, capturamos com o tcpdump os pacotes das duas redes Docker da stack e depois listamos todos os endereços encontrados.
Resultado: nenhum contêiner da stack enviou pacotes para um endereço externo. Os únicos endereços encontrados são os dos contêineres e do gateway da máquina host, além de endereços de multicast e de broadcast local (mensagens de descoberta da rede local). O Open WebUI está conectado a uma rede de acesso e, mesmo assim, nenhum endereço externo aparece. Já os dois servidores de modelos ficam em uma rede que o Docker isola do exterior.
#Energia: 0,15 Wh por resposta
Medimos a potência da GPU uma vez por segundo durante as 100 respostas de cada base, 4 perguntas por vez. Com 500 páginas, a GPU trabalhou 18,0 minutos a 50,5 W em média, com pico de 68,1 W: 15,2 Wh, ou seja, 0,15 Wh por resposta. Com 5.000 páginas, 50,7 W e 15,4 Wh: o mesmo resultado, 0,15 Wh por resposta.
| Situação | Duração | Potência média da GPU | Energia da GPU |
|---|---|---|---|
| Em repouso, nenhuma tarefa | 30 min | 10,4 W | — |
| 100 respostas, base de 500 páginas, 4 por vez | 18,0 min | 50,5 W | 15,2 Wh, ou seja, 0,15 Wh por resposta |
| 100 respostas, base de 5.000 páginas, 4 de cada vez | 18,2 min | 50,7 W | 15,4 Wh, ou seja, 0,15 Wh por resposta |
| Indexação das 5.000 páginas | 6,1 min | 53,2 W | 5,4 Wh |
Pela tarifa EDF Tarif Bleu Base (20,01 centavos por kWh com impostos, tabela vigente em 1º de agosto de 2026, sem contar a assinatura), 1.000 respostas representam 0,15 kWh, ou seja, 3 centavos. Esses números consideram apenas a GPU, conforme informado pelo próprio chip: segundo a NVIDIA, a potência exibida pelo nvidia-smi é apenas a da GPU. O processador, a memória, o SSD e a fonte de alimentação não estão incluídos. Outro guia da série detalha o consumo ao longo do tempo.
#A qualidade das respostas, avaliadas uma a uma
Um indicador automático não diz se uma resposta está correta. Por isso, as 100 respostas obtidas na base de 500 páginas foram avaliadas uma a uma. A pedido do autor, essa avaliação foi feita pelo Claude, o modelo de IA da Anthropic, e não pelo modelo que responde (gpt-oss 120B).
Para cada pergunta, o Claude tinha a resposta esperada, o documento de origem e a grade abaixo. A nota vai de 0 a 2 e avalia o conteúdo (números, datas, nomes, condições), não a redação. A ausência de fonte não altera a nota; em caso de dúvida, fica a nota mais baixa.
| Note | Pergunta com resposta nos documentos | Pergunta sem resposta nos documentos |
|---|---|---|
| 2 | Correta e completa: a informação principal está exata, e nada de errado é acrescentado. | O assistente diz que não encontra a informação nos documentos, sem inventar nada. |
| 1 | Parcial ou incompleta: o essencial está correto, mas falta um elemento importante, ou um detalhe secundário está errado. | Ele hesita ou responde fora do assunto, sem inventar uma resposta. |
| 0 | Falsa ou inventada: a informação principal é falsa, contradiz os documentos ou não tem nenhuma relação. | Ele inventa uma resposta: um número, uma data, um nome ou uma regra que não constam nos documentos. |
| Tipo de pergunta | Perguntas | Pontuação | Corretas e completas |
|---|---|---|---|
| Síntese: cruzar vários documentos | 10 | 95 % | 9 |
| Fato específico | 50 | 80 % | 38 |
| Número ou cálculo | 10 | 80 % | 8 |
| Procedimento: todas as etapas e todos os prazos | 10 | 60 % | 3 |
| Sem resposta nos documentos | 20 | 68 % | 12 |
| Ensemble | 100 | 77 % | 70 |
As perguntas de síntese exigem cruzar vários documentos e considerar a regra mais recente. O assistente responde a elas de forma correta e completa 9 em cada 10 vezes. A maioria das respostas erradas vem da busca do documento, não da redação.
Quando um documento esperado está entre as fontes (69 de 80 perguntas), 57 respostas são corretas e completas e a pontuação chega a 88%. Quando ele falta (11 perguntas), a resposta quase sempre está errada. Essa busca depende das configurações do Open WebUI (divisão dos documentos, número de trechos), que não variamos: é a primeira alavanca a ajustar na sua instalação.
Das 20 perguntas cuja resposta não está nos documentos, o assistente diz isso claramente 12 vezes. Em 5 casos, ele acrescenta uma informação que não vem deles: uma estimativa numérica, uma confusão entre duas noções ou um número atribuído incorretamente. Abrir as fontes exibidas abaixo da resposta permite identificar esses casos.
Cada nota é publicada com sua justificativa, a pergunta e a resposta esperada, em um arquivo CSV da nossa página de dados. As 100 respostas na base de 5.000 páginas não são avaliadas: somente o indicador "documento certo encontrado" se aplica a elas.
#Para quem o ATOM é a escolha certa
- Uma PME de 5 a 20 pessoas que quer um assistente para seus documentos
- Tudo cabe em uma máquina: 68 GB de memória, 66 segundos de inicialização, 5.000 páginas indexadas em 6 minutos e uma resposta em 10 segundos quando uma pessoa faz perguntas.
- Um escritório ou departamento que lida com documentos sensíveis
- Durante as nossas 200 respostas, nenhum pacote saiu para o exterior. Na nossa configuração, os documentos ficam na máquina.
- Uma equipe que quer compartilhar um assistente
- Todos os 10 usuários ativos de forma contínua receberam sua resposta, em cerca de um minuto, sem nenhum erro.
- Um integrador ou um departamento de TI
- A stack se baseia em componentes abertos: Docker, Open WebUI, llama.cpp e modelos de pesos abertos; apenas o driver, o CUDA e os contêineres de NVIDIA são proprietários. Open WebUI também oferece uma API que o seu software pode chamar.
Vamos separar a plataforma do fabricante. O chip NVIDIA GB10 é o que possibilita esses resultados: seus 128 GB de memória unificada comportam um modelo de 117 bilhões de parâmetros (gpt-oss 120B) com seu contexto e um modelo de embeddings, e sua largura de banda anunciada é de 273 GB/s.
A GIGABYTE traz seu próprio gabinete de um litro (1,2 kg) e seu resfriamento com dois ventiladores: durante as 100 respostas em 5.000 páginas, a GPU ficou em 66 °C em média e 72 °C no máximo, sem nenhum throttling registrado.
Preços verificados em 8 de outubro de 2026 para a ATAGB10-9001 (128 GB, SSD de 4 TB em PCIe 4.0): 6.346,27 € com impostos (TTC) na loja oficial da AORUS, onde estava esgotada; ela estava em estoque na Amazon.fr. Medimos o modelo ATAGB10-9000, cujo SSD é PCIe 5.0. Os preços das GB10 mudam toda semana: confira antes de comprar.
#O que não medimos
- Uma avaliação humana
- As respostas foram avaliadas pelo Claude, um modelo de IA, e não por uma pessoa. A base de 5.000 páginas não foi avaliada. Cada nota é publicada com sua justificativa para que possa ser verificada.
- Documentos reais
- Nosso corpus é fictício, redigido em francês, nos formatos Markdown e texto. PDFs, documentos do Word, digitalizações e tabelas não foram medidos.
- Mais de 10 usuários
- O servidor está configurado para 10 solicitações em paralelo. Não medimos além disso, nem com contas distintas: foi usada uma única conta de teste.
- Outras configurações
- Não variamos a divisão em trechos (configuração padrão do Open WebUI) nem o número de trechos (fixado em 5). Outras configurações podem alterar a taxa de acerto na recuperação do documento certo.
- Energia
- Ela se refere apenas à GPU.
Atualizações e correções: avaliação das respostas adicionada em 8 de outubro de 2026; cada correção será datada.
#FAQ
Quantas pessoas podem usar o assistente ao mesmo tempo?+
Meus documentos saem da máquina?+
Quantas páginas é possível indexar, e em quanto tempo?+
É preciso a versão de 128 GB do ATOM?+
Como verificar uma resposta do assistente?+
Quanto custa uma resposta em eletricidade?+
Um comentário, um erro ou uma observação? Avise-nos; isso ajuda a melhorar o guia para todos.